

Transformer Mimarisi Nedir?
Kısa tanım
Transformer, 2017'de yayımlanan “Attention Is All You Need” makalesiyle tanıtılan ve dikkat (attention) mekanizmasına dayanan sinir ağı mimarisidir. Metni kelime kelime sırayla işlemek yerine bir dizideki tüm token'ları birlikte ele alır ve her birinin diğerleriyle ne kadar ilişkili olduğunu hesaplar. Bugünkü büyük dil modellerinin ve birçok görüntü ve çok kipli modelin temelinde bu mimari bulunur.
Diğer adları: Transformer, Transformer modeli, dikkat mekanizması, attention, self-attention, öz-dikkat
Transformer'dan önce dil nasıl işleniyordu?
2017'ye kadar dil işlemede yaygın yaklaşım, RNN ve LSTM gibi yinelemeli ağlardı. Bu ağlar cümleyi soldan sağa, bir kelimeyi işledikten sonra ötekine geçerek okur. Bu iki soruna yol açıyordu: Uzun bir cümlenin başındaki bir bilgi sona gelindiğinde zayıflıyordu ve işlem sıralı olduğu için eğitim, modern donanımda paralel çalıştırılmaya pek elverişli değildi.
Google araştırmacılarının “Attention Is All You Need” başlıklı makalesi, yinelemeyi tümüyle bırakıp yalnızca dikkat mekanizmasına dayanan bir mimari önerdi. Makalede ilk sınanan görev makine çevirisiydi; ancak mimari kısa sürede dilin neredeyse her alanına, ardından görüntü ve sese yayıldı.
Dikkat mekanizması: her token diğerlerine bakar
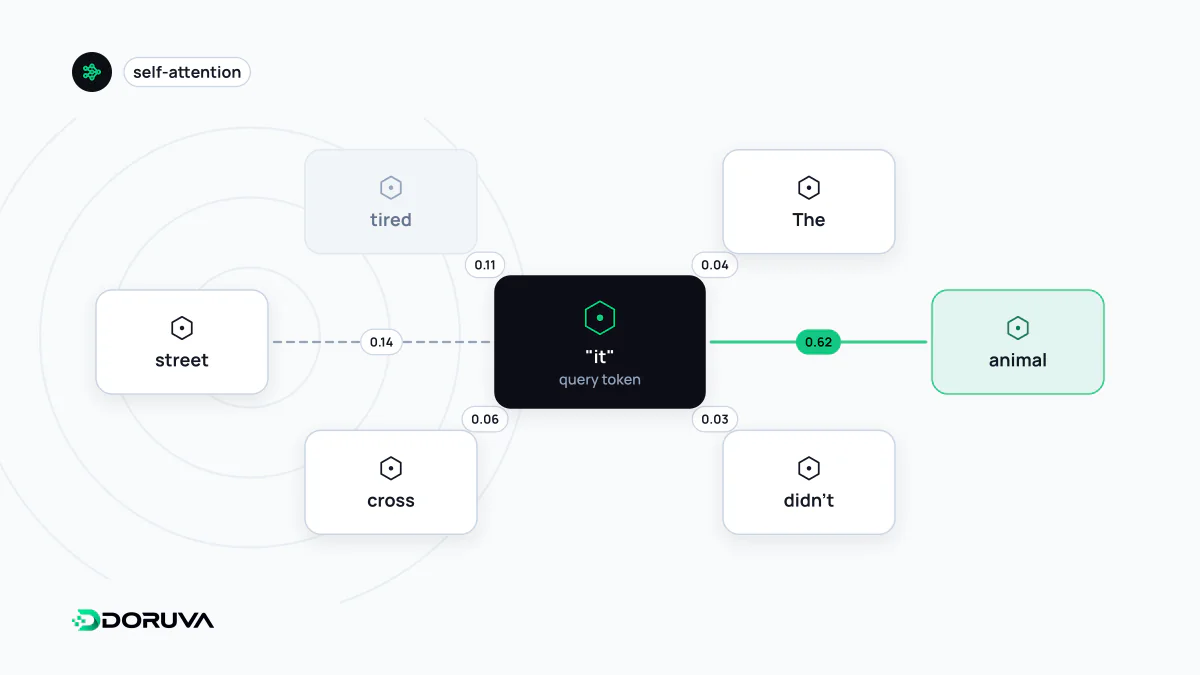
“Kediyi veterinere götürdük, çünkü o iki gündür yemek yemiyordu.” cümlesinde “o” zamirinin kediyi gösterdiğini bir insan hemen anlar. Dikkat mekanizması bu tür ilişkileri sayısal olarak kurar. Kavramsal olarak her token için üç vektör üretilir:
- Sorgu (query): “Ben neyle ilişkiliyim?” sorusunun temsili.
- Anahtar (key): Her token'ın kendini diğerlerine tanıttığı etiket.
- Değer (value): Token'ın aktaracağı asıl içerik.
Bir token'ın sorgusu, dizideki bütün anahtarlarla karşılaştırılır; uyum puanları ağırlığa dönüştürülür ve değerler bu ağırlıklarla harmanlanır. Böylece “o” token'ının yeni temsili, büyük ölçüde “kedi” token'ından beslenir. Model bunu tek bir bakışla değil, aynı anda çalışan birçok dikkat başlığıyla (multi-head attention) yapar; bir başlık zamir ilişkilerini, bir diğeri özne-yüklem uyumunu yakalayabilir. Dikkat kendi başına sıraya duyarsız olduğu için token'ların konum bilgisi ayrıca eklenir.
Encoder, decoder ve bugünkü model aileleri
| Yapı | Örnek aileler | Tipik kullanım |
|---|---|---|
| Yalnızca encoder | BERT ve türevleri | Sınıflandırma, varlık tanıma, embedding üretimi |
| Yalnızca decoder | GPT tarzı modeller | Metin ve kod üretimi, sohbet |
| Encoder-decoder | Orijinal Transformer, T5 | Çeviri, özetleme |
Bugün sohbet asistanlarının arkasındaki büyük dil modellerinin çoğu yalnızca decoder kullanır ve metni token token üretir. Encoder tabanlı modeller ise anlamsal aramada kullanılan embedding vektörlerinin yaygın kaynağıdır.
Mimarinin bedeli: bağlam uzadıkça artan maliyet
Standart dikkat mekanizmasında her token diğer her token'la karşılaştırılır. Dizi iki katına çıktığında karşılaştırma sayısı kabaca dört katına çıkar. Modellerin bir seferde işleyebildiği metin miktarının, yani bağlam penceresinin sınırlı olmasının ve uzun girdilerin daha pahalı olmasının temel nedenlerinden biri budur. Bu maliyeti azaltan pek çok dikkat varyantı geliştirilmiştir, ama hesap ile bellek arasındaki denge her mimaride bir tasarım kararı olarak kalır. Maliyetin token üzerinden ölçülmesi de bu yapının doğrudan sonucudur.
Bilmek pratikte neye yarar?
Transformer'ı anlamak model seçmeyi ve sonuçları yorumlamayı kolaylaştırır. Modelin bir cevabı neden bağlamdaki belgeye dayandırabildiğini, neden çok uzun girdilerde ortadaki ayrıntıyı kaçırabildiğini ya da neden aynı kelimenin farklı cümlelerde farklı temsil aldığını açıklar. Kelimeyi sabit bir sözlük anlamıyla değil, çevresiyle birlikte temsil etmek, modern doğal dil işlemenin eski anahtar kelime eşleştirme yöntemlerinden ayrıldığı noktadır.