

Embedding (Vektör Temsili) Nedir?
Kısa tanım
Embedding (vektör temsili), bir metni, görseli ya da başka bir veriyi anlamını yansıtan sayılardan oluşan bir vektöre dönüştürme yöntemi ve bu dönüşümün sonucudur. Anlamca birbirine yakın içeriklerin vektörleri de birbirine yakın olur; bu sayede kelimeler birebir eşleşmese bile benzer içerikler bulunabilir. Anlamsal arama, RAG ve öneri sistemleri bu temsile dayanır.
Diğer adları: vektör temsili, gömme, vector embedding, metin vektörü
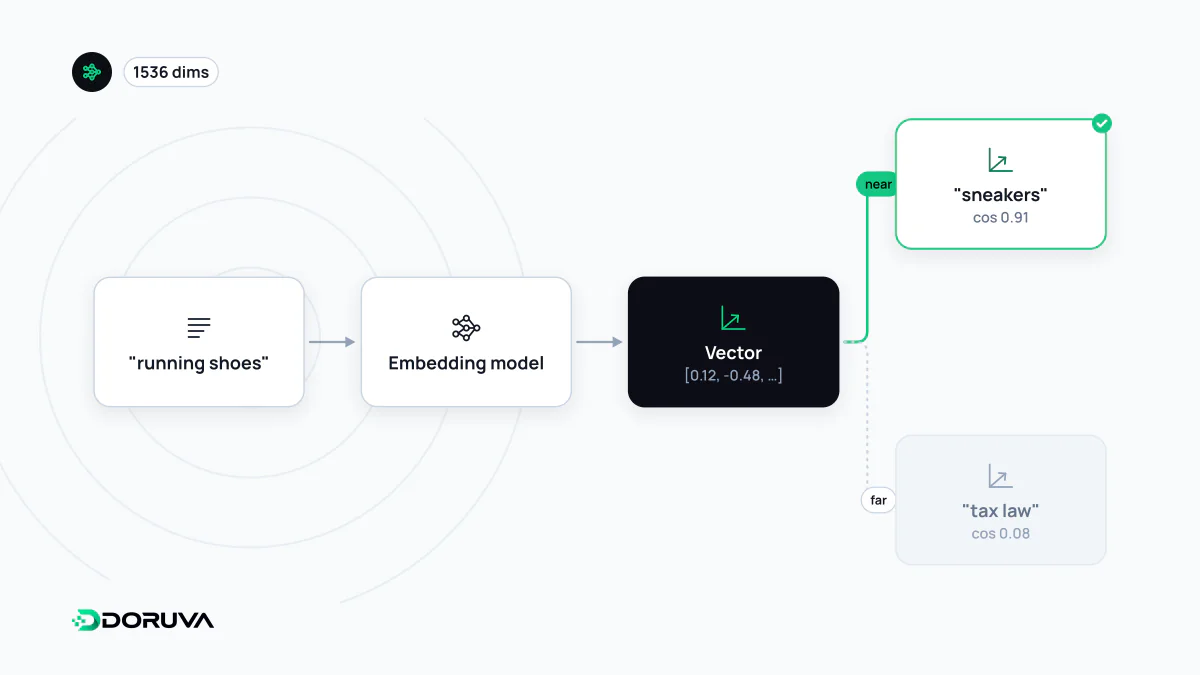
Anlamı sayılarla ifade etmek
Bilgisayar "kargo" ile "gönderi" kelimelerinin yakın anlamlı olduğunu harf dizisine bakarak anlayamaz. Embedding modeli bu boşluğu doldurur: kendisine verilen metni yüzlerce ya da binlerce boyutlu bir sayı dizisine çevirir. Bu sayıların tek tek bir anlamı yoktur; önemli olan, vektörlerin uzaydaki konumlarının birbirine göre nasıl durduğudur. Model, eğitim sırasında benzer bağlamlarda geçen ifadeleri birbirine yakın konumlara yerleştirmeyi öğrenmiştir.
Benzerlik nasıl ölçülür?
İki vektörün yakınlığı çoğunlukla kosinüs benzerliği ile ölçülür: vektörler aynı yönü gösteriyorsa sonuç 1'e yaklaşır, alakasızlaştıkça düşer. Aşağıdaki örnek yalnızca fikri göstermek içindir; gerçek vektörler çok daha uzundur ve bu değerler temsilidir:
"kargom ne zaman gelir"      → [0.81, 0.12, -0.33, ...]
"siparişimin teslim süresi"  → [0.78, 0.15, -0.29, ...]   benzerlik: yüksek
"şifremi nasıl sıfırlarım"   → [-0.10, 0.64, 0.42, ...]   benzerlik: düşük
İlk iki cümle neredeyse hiç ortak kelime içermez, ama anlamları yakın olduğu için vektörleri de yakındır. Klasik anahtar kelime eşleşmesinin kaçırdığı bu ilişki, anlamsal aramanın temelidir.
Nerelerde kullanılır?
- Arama: Sorguya anlamca en yakın belgeleri bulmak.
- RAG sistemleri: Bir dil modeline cevap yazmadan önce okutulacak belge parçalarını seçmek.
- Öneri: Okunan içeriğe benzeyen makaleleri ya da ürünleri listelemek.
- Kümeleme ve sınıflandırma: Destek taleplerini, yorumları ya da sayfaları konularına göre gruplamak.
- Tekrar tespiti: Farklı kelimelerle yazılmış ama aynı şeyi anlatan içerikleri yakalamak.
Sık yapılan hatalar
- Farklı modellerin vektörlerini karşılaştırmak: Her embedding modeli kendi uzayını oluşturur. Bir modelle üretilen belge vektörü, başka bir modelle üretilen sorgu vektörüyle anlamlı biçimde kıyaslanamaz. Model değiştiğinde tüm içeriğin yeniden vektörleştirilmesi gerekir.
- Boyut sayısını kalite ölçüsü sanmak: Daha fazla boyut her zaman daha iyi sonuç anlamına gelmez; depolama ve sorgu maliyetini ise kesin olarak artırır. Doğru seçim, kendi verinizle yapılan testlerle belirlenir.
- Çok uzun parçalar: Birçok farklı konuyu içeren uzun bir metin tek bir vektöre sıkıştırıldığında anlam bulanıklaşır. Bu yüzden belgeler genellikle başlık ya da paragraf düzeyinde parçalara bölünür.
- Embedding'i dil modeliyle karıştırmak: Embedding modeli metin üretmez; yalnızca temsil üretir. Cevabı yazan, ayrı bir LLM'dir.
Bir sistem kurarken iyi uygulamalar
- Sorgu ve belgeler için aynı modeli ve aynı ön işleme adımlarını kullanın.
- Vektörün yanında kaynak URL, başlık ve tarih gibi meta verileri saklayın; filtreleme ve kaynak gösterme için gerekir.
- Anlamsal aramayı, ürün kodu ya da özel isim gibi birebir eşleşme gerektiren durumlar için anahtar kelime aramasıyla birlikte kullanmayı değerlendirin.
- Sonuç kalitesini gerçek kullanıcı sorularından oluşan bir test setiyle düzenli olarak ölçün.
İçerik açısından anlamı
Anlam tabanlı eşleşme, bir kavramın her eş anlamlısını sayfaya serpiştirme ihtiyacını azaltır. Asıl fark yaratan, sayfanın konusunu açık ve odaklı biçimde ele alması, bölümlerin tek bir soruyu net yanıtlamasıdır. Konu dağınık olduğunda, o bölümün vektörü de hiçbir soruya tam yakın düşmez.