

LLM (Büyük Dil Modeli) Nedir?
Kısa tanım
LLM (Large Language Model, büyük dil modeli), çok büyük metin koleksiyonları üzerinde eğitilerek dildeki örüntüleri öğrenen ve bir girdiye karşılık metni token token tahmin ederek üreten yapay zekâ modelidir. ChatGPT, Claude ve Gemini gibi asistanların temelinde LLM'ler bulunur; soru yanıtlama, özetleme, çeviri ve kod yazma gibi işlerde kullanılır.
Diğer adları: Large Language Model, büyük dil modeli, dil modeli, LLM'ler
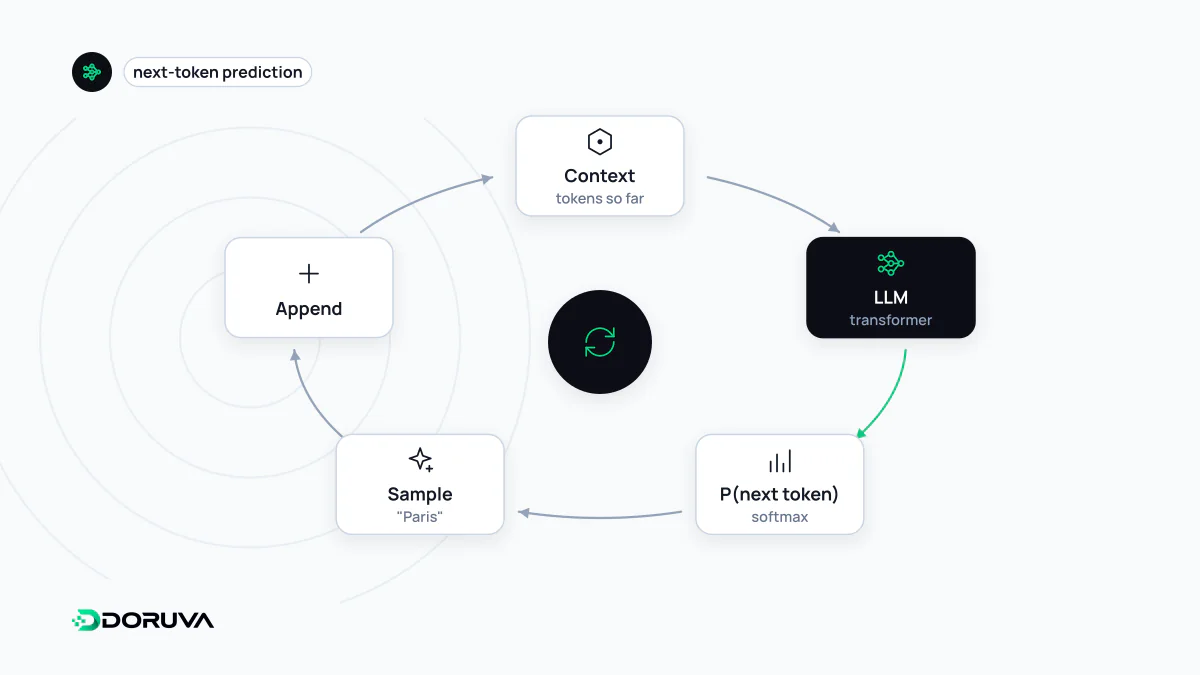
Bir LLM metni nasıl üretir?
LLM'ler metni kelime kelime değil, token adı verilen parçalarla işler. Bir token bir kelime, bir kelimenin parçası ya da bir noktalama işareti olabilir. Model, kendisine verilen metni (prompt) okur ve sıradaki token için olası tüm seçeneklere bir olasılık atar; seçilen token metne eklenir ve döngü cevap bitene kadar sürer. Bugün yaygın kullanılan modellerin büyük çoğunluğu 2017'de tanıtılan Transformer mimarisine dayanır. Bu mimarideki dikkat (attention) mekanizması, girdideki her parçanın diğerleriyle ilişkisini hesaplayarak bağlamın yakalanmasını sağlar.
Modelin tek seferde hesaba katabildiği metin miktarı sınırlıdır; bu sınıra bağlam penceresi denir. Uzun bir belgeyi ya da çok sayıda kaynağı aynı anda işlemek isteyen sistemler bu sınıra göre tasarlanır.
Eğitim aşamaları
- Ön eğitim (pre-training): Model; web sayfaları, kitaplar ve kod depoları gibi geniş metin kaynaklarında sıradaki token'ı tahmin etmeyi öğrenir. Dil bilgisi, olgular ve akıl yürütme kalıpları bu aşamada model parametrelerine işlenir.
- İnce ayar (fine-tuning): Ön eğitimli model, talimatlara uymayı ve diyalog kurmayı öğrenmesi için özenle seçilmiş örneklerle yeniden eğitilir.
- Hizalama: Birçok sağlayıcı, insan değerlendirmelerinden yararlanan yöntemlerle (RLHF gibi) modeli daha yararlı ve güvenli cevaplara yönlendirir.
Hangi verinin hangi oranda kullanıldığı çoğu zaman ayrıntılı biçimde açıklanmaz. Bu yüzden belirli bir modelin belirli bir siteyi "tanıdığını" ya da "tanımadığını" dışarıdan kesin olarak söylemek mümkün değildir.
Eğitim verisi ile canlı web aynı şey değil
Model parametrelerindeki bilgi, eğitim verisinin toplandığı tarihte donar; buna bilgi kesim tarihi (knowledge cutoff) denir. Güncel bir fiyatı, yeni çıkan bir ürünü ya da dün yayımlanmış bir haberi aktarabilmesi için modelin bu bilgiyi cevap anında dışarıdan alması gerekir. Yapay zekâ arama ürünlerinin çoğu bunu RAG yaklaşımıyla yapar: önce bir dizinden ya da web'den ilgili sayfaları getirir, ardından cevabı bu kaynaklara dayanarak yazar ve çoğu zaman kaynak gösterir.
Site sahipleri için bu ayrım pratik bir sonuç doğurur: içeriğin model eğitiminde kullanılması ile bir yapay zekâ aramasında anlık olarak getirilip alıntılanması farklı süreçlerdir ve genellikle farklı yapay zekâ tarayıcıları tarafından yürütülür. Birini engellemek diğerini otomatik olarak engellemez.
Sınırlamalar
- Uydurma bilgi: Modelin hedefi doğruluğu garanti etmek değil, makul bir devam metni üretmektir; bu yüzden akıcı ama yanlış ifadeler ortaya çıkabilir. Bu duruma halüsinasyon denir.
- Güncellik: Dış kaynak kullanılmadığında bilgi kesim tarihinden sonraki gelişmeler bilinmez.
- Tutarlılık: Aynı soru farklı zamanlarda farklı cevaplar üretebilir; çıktılar her zaman birebir tekrarlanmaz.
- İzlenebilirlik: Parametrelerden gelen bir bilginin hangi belgeden öğrenildiği genellikle gösterilemez.
Yaygın yanlış anlamalar
- "Model internette arama yapıyor." Arama, modelin kendisinde değil, etrafındaki ürün katmanında (arama araçları, getirme sistemleri) gerçekleşir. Aynı model, arama aracı açık ya da kapalı olarak çok farklı cevaplar verebilir.
- "LLM bilgiyi veritabanı gibi saklar." Bilgi kayıtlar halinde tutulmaz; milyarlarca parametreye dağılmış istatistiksel ilişkiler olarak bulunur. Belirli bir bilgiyi modelden "silmek" ya da "düzeltmek" bu yüzden basit bir işlem değildir.
İçerik üretenler için anlamı
LLM tabanlı asistanlar bir markayı ya da konuyu anlatırken erişebildikleri kaynaklardaki ifadelere dayanır. Kavramları açıkça tanımlayan, olguları tutarlı veren, kim olduğunuzu ve ne sunduğunuzu net anlatan sayfalar doğru aktarılma ve kaynak gösterilme ihtimalini artırabilir; yine de hiçbir yöntem belirli bir cevapta yer almayı garanti etmez. Bu alandaki çalışmaların bütününe GEO (üretken motor optimizasyonu) denir.