

Temel Model (Foundation Model) Nedir?
Kısa tanım
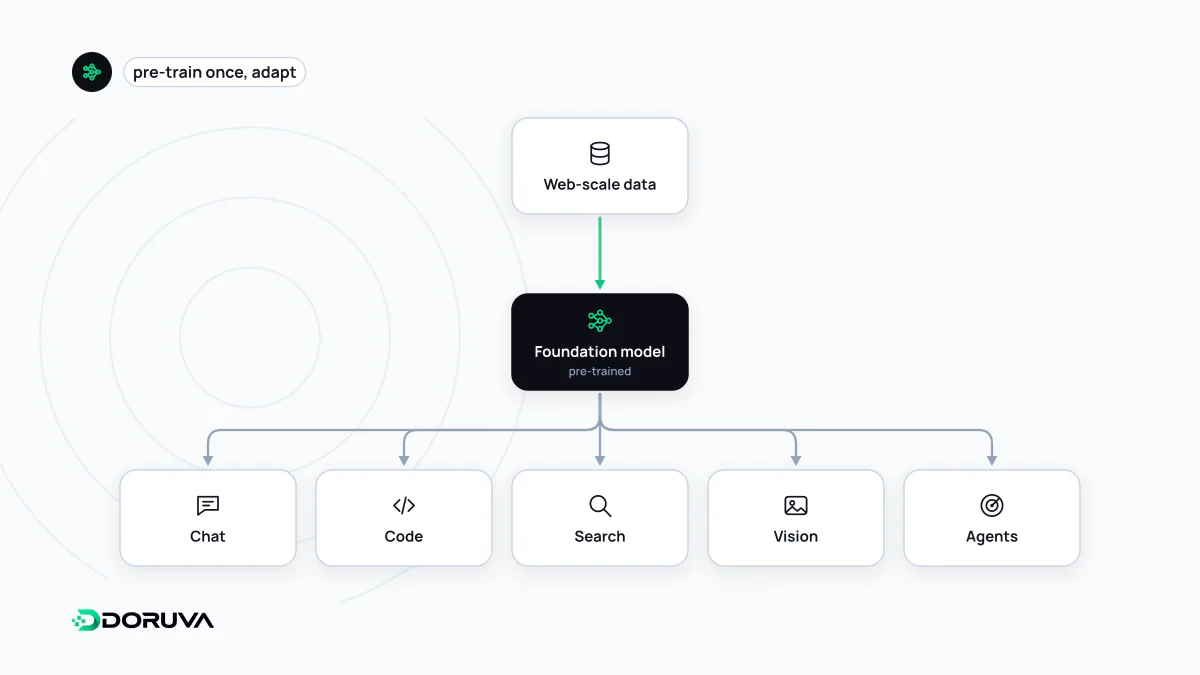
Temel model (foundation model), çok geniş ve çeşitli veriler üzerinde büyük ölçekte, çoğunlukla kendi kendine denetimli yöntemlerle eğitilen ve ince ayar, talimatlar ya da ek bileşenlerle çok farklı görevlere uyarlanabilen yapay zekâ modelidir. Terim 2021'de Stanford araştırmacılarınca yaygınlaştırıldı. Büyük dil modelleri bu sınıfın en bilinen örneğidir; görüntü, ses ve çok kipli modeller de temel model olabilir.
Diğer adları: foundation model, genel amaçlı yapay zekâ modeli, base model, ön eğitimli model
Terimin kaynağı
"Foundation model" ifadesi, Stanford Üniversitesi'ndeki Center for Research on Foundation Models ekibinin Ağustos 2021'de yayımladığı kapsamlı raporla yerleşti. Rapor bu modelleri "geniş veri üzerinde büyük ölçekte eğitilen ve çok çeşitli alt görevlere uyarlanabilen modeller" olarak tanımlar ve örnek olarak BERT, GPT-3 ve DALL-E'yi verir. Yazarlar "temel" kelimesini bilinçli seçtiklerini anlatır: bu modeller birçok uygulamanın altında yatan ortak katmandır, ama kendileri tamamlanmış bir ürün değildir. Temeldeki bir kusur, üzerine kurulan her uygulamaya taşınabilir.
Avrupa Birliği'nin Yapay Zekâ Yasası (Tüzük (AB) 2024/1689) benzer modeller için "genel amaçlı yapay zekâ modeli" kavramını kullanır ve bunları geniş bir görev yelpazesini yetkin biçimde yerine getirebilen, farklı sistemlere entegre edilebilen modeller olarak tarif eder. Hukuki tanımın kapsamı ve yükümlülükleri ayrı bir konudur; buradaki ortak nokta genellik ve uyarlanabilirliktir.
Temel model ve büyük dil modeli aynı şey mi?
Hayır. Büyük dil modeli (LLM), metin üzerinde eğitilip metin üreten bir model türüdür ve günümüzün en görünür temel modelleridir. Temel model ise veri türünden bağımsız bir şemsiye kavramdır:
| Model ailesi | Girdi ve çıktı | Tipik kullanım |
|---|---|---|
| Dil modelleri | Metin → metin | Sohbet asistanları, özetleme, kod üretimi |
| Görüntü üretim modelleri | Metin → görüntü | Görsel tasarım, illüstrasyon |
| Konuşma modelleri | Ses ↔ metin | Transkripsiyon, sesli asistan |
| Çok kipli modeller | Metin, görüntü, ses birlikte | Görsel hakkında soru yanıtlama, belge okuma |
| Embedding modelleri | Metin veya görüntü → vektör | Anlamsal arama, öneri sistemleri |
Tek bir görev için küçük veriyle eğitilmiş bir spam sınıflandırıcısı ise ne kadar iyi çalışırsa çalışsın temel model sayılmaz; genellik ve uyarlanabilirlik bu tanımın özüdür. Farklı veri türlerini birlikte işleyen modeller çok kipli model başlığında ayrıca ele alınır.
Uyarlama yolları
Bir temel modeli belirli bir işe uygun hâle getirmenin başlıca yolları şunlardır:
- Talimat ve örneklerle yönlendirme: Model değiştirilmez; görev, prompt içinde açıklanır ve birkaç örnek verilir.
- İnce ayar: Modelin ağırlıkları, göreve özgü daha küçük bir veri setiyle yeniden eğitilir. Ham "base" modelin sohbet asistanına dönüşmesi de bu tür bir eğitim sürecinin sonucudur. Ayrıntılar ince ayar sayfasındadır.
- Dış bilgiyle besleme: Model aynı kalır, ama soru sorulduğunda ilgili belgeler bulunup bağlama eklenir. RAG bu yaklaşımın adıdır ve güncel bilgi gerektiren işlerde ince ayardan çoğu zaman daha pratiktir.
Web siteleri ve markalar için anlamı
Bugün kullanılan pek çok sohbet asistanı, arama özelliği ve kurumsal araç, sayıca az bir grup temel modelin üzerine kurulur. Bu iki sonuç doğurur. Birincisi, bir modelin eğitim verisinden öğrendiği bilgi, yani parametrik bilgi, belirli bir tarihte donar; markanız hakkındaki güncel bilgiler ancak web araması gibi dış kaynaklarla yanıta girer. İkincisi, temel modeldeki bir yanlış ya da eksik, o modeli kullanan birçok üründe aynı anda görülebilir. Markaya dair bilgilerin web'de tutarlı, açık ve doğrulanabilir olması bu yüzden önemlidir.
Temel modeller güçlü olsa da yanılmaz değildir: eğitim verisindeki önyargıları taşıyabilir ve gerçekte olmayan bilgileri akıcı biçimde üretebilir. Bu ikinci sorun halüsinasyon olarak bilinir ve uyarlama yöntemleri onu azaltabilir, ama tamamen ortadan kaldırmaz.