

Çok Kipli Model (Multimodal Model) Nedir?
Kısa tanım
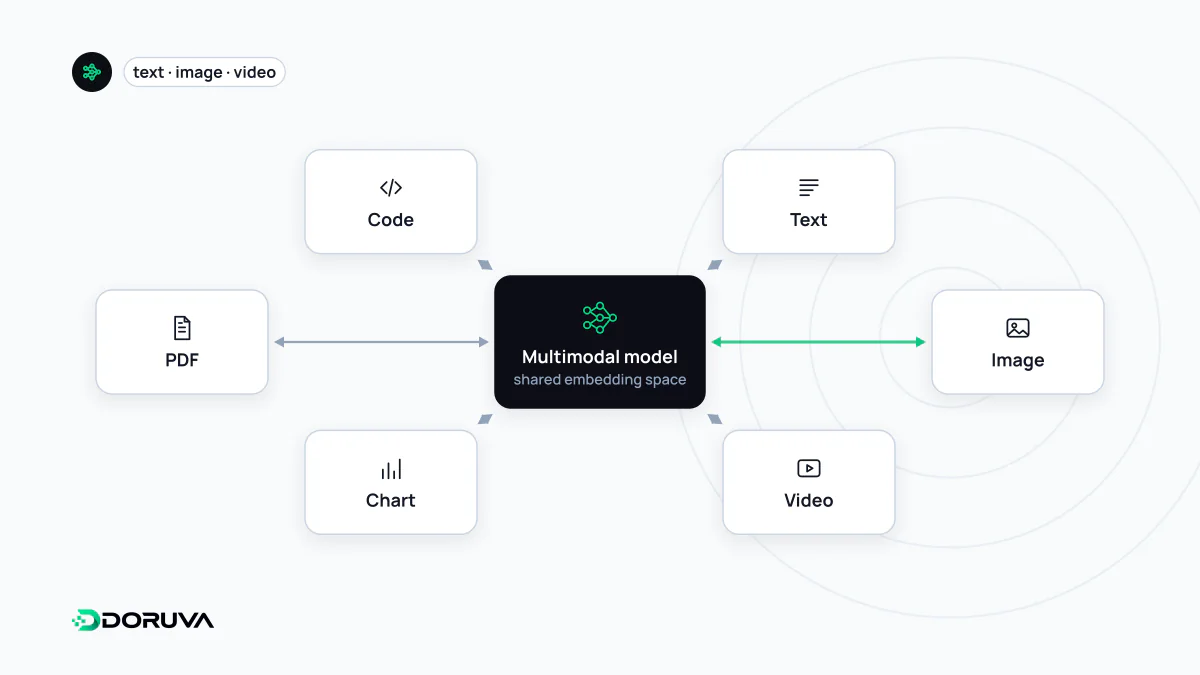
Çok kipli model (multimodal model), metin, görsel, ses veya video gibi birden fazla veri türünü (kipi) girdi olarak alabilen ya da çıktı olarak üretebilen yapay zekâ modelidir. Böyle bir model bir fotoğrafı yorumlayıp hakkındaki soruyu yanıtlayabilir, bir grafiği okuyabilir ya da metinden görsel üretebilir. Farklı kipler ortak bir temsil uzayında işlendiği için model, bir görseldeki nesneyi onu anlatan kelimeyle ilişkilendirebilir.
Diğer adları: multimodal model, multimodal yapay zekâ, çok modlu model, görsel-dil modeli, VLM
Bir görsel modele nasıl “okutulur”?
Dil modelleri token dizileriyle çalışır; çok kipli bir modelin işi, diğer veri türlerini de bu diziye katılabilecek biçime getirmektir. Bir görsel genellikle küçük karelere (patch) bölünür, bir görüntü kodlayıcısı her kareyi bir vektöre çevirir ve bu vektörler metin token'larıyla aynı temsil uzayına yansıtılır. Ses için de benzer biçimde kısa zaman dilimleri vektörleştirilir. Bundan sonra Transformer katmanları görsel parçalarla kelimeler arasında da dikkat ilişkisi kurabilir; “sol alttaki etiket ne yazıyor?” sorusu bu sayede cevaplanır.
Bu ortak uzay fikri, görsel ve metinleri aynı vektör alanına yerleştiren embedding modellerinin de temelidir; bir metinle görsel aramak bu yolla mümkün olur.
Kip kombinasyonları
| Girdi → çıktı | Örnek kullanım |
|---|---|
| Görsel + metin → metin | Ekran görüntüsündeki hatayı açıklama, faturadan alan okuma, grafik yorumlama |
| Metin → görsel | Taslak illüstrasyon, kampanya görseli varyasyonları |
| Ses → metin | Toplantı dökümü, sesli komut |
| Metin → ses | Seslendirme, sesli asistan cevapları |
| Video → metin | Videoyu özetleme, belirli bir anı bulma |
Her çok kipli model bütün bu kombinasyonları desteklemez. Bir kısmı yalnızca görseli anlayıp metin üretir, bir kısmı görsel de üretir. Hangi kiplerin desteklendiği model kartında ya da sağlayıcı dokümantasyonunda yazar ve sürümden sürüme değişebilir.
Web içeriği açısından ne değişiyor?
Yapay zekâ sistemleri artık ekran görüntülerini, PDF'leri, tabloları ve ürün fotoğraflarını da yorumlayabiliyor. Bu, bilginin metin dışındaki biçimlerde de okunabileceği anlamına gelir; ama metnin önemini azaltmaz:
- Arama ve getirme sistemlerinin büyük bölümü hâlâ öncelikle metni dizinler. Fiyatı ya da kampanya koşulunu yalnızca bir banner görselinin içine yazmak, o bilginin bulunma ihtimalini düşürür.
- Alt metin, ekran okuyucu kullananlar için zorunlu bir erişilebilirlik öğesidir; bir modelin görseli kendi başına yorumlayabilmesi bu gerekliliği ortadan kaldırmaz.
- Dosya adı, görsel başlığı ve görselin yakınındaki açıklama metni, görsel SEO için de, çok kipli sistemlerin görseli doğru bağlama yerleştirmesi için de işe yarar.
Sınırlar ve dikkat edilecekler
- Görsel halüsinasyon: Model görselde olmayan bir nesneyi “görebilir” ya da küçük yazıları yanlış okuyabilir.
- Sayma ve konum: Nesne saymak, sağ-sol ilişkisini ya da ölçek farklarını doğru yorumlamak sık hata yapılan işlerdir.
- Veri gizliliği: Fatura, kimlik ya da ekran görüntüsü yüklemek, içlerindeki kişisel verileri de modele göndermek demektir; kurum içi kullanımda hangi verinin hangi sağlayıcıya gittiği netleştirilmelidir.
Pek çok güncel temel model doğrudan çok kipli olarak eğitiliyor; “dil modeli” ile “görsel model” arasındaki sınır bu yüzden giderek bulanıklaşıyor.