

Token (Yapay Zekâ) Nedir?
Kısa tanım
Token, dil modellerinin metni işlerken kullandığı temel birimdir; bir kelime, kelimenin bir parçası, bir noktalama işareti veya boşlukla birleşmiş bir harf dizisi olabilir. Metni tokenlara bölen bileşene tokenizer denir ve her model ailesinin kendi tokenizer'ı vardır. Bağlam penceresi, çıktı sınırları ve API ücretleri token cinsinden hesaplanır. Token sayısı kelime sayısına eşit değildir; Türkçe metinler çoğu tokenizer'da İngilizceye göre daha fazla token tutar.
Diğer adları: tokenizer, tokenizasyon, belirteç, LLM token, alt kelime birimi
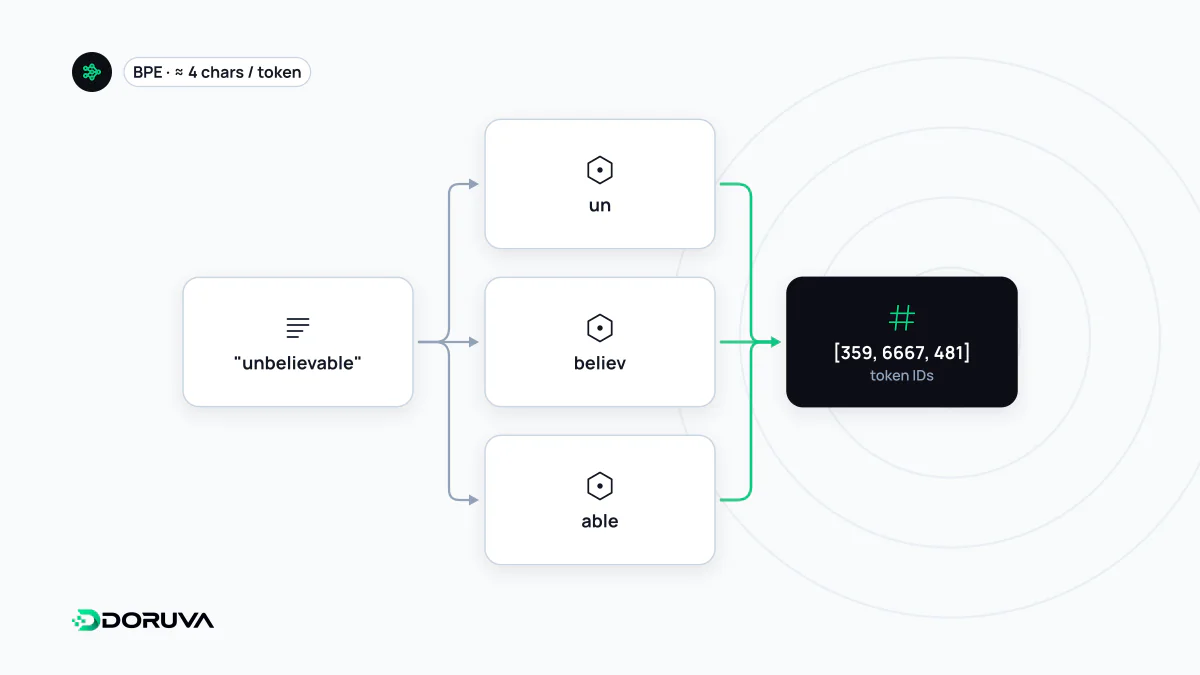
Token bir kelime değildir
Bir dil modeli metni harf harf ya da kelime kelime değil, tokenlar hâlinde okur ve yazar. Sık geçen kısa kelimeler genellikle tek bir tokendır. Daha nadir ya da uzun kelimeler birkaç parçaya bölünür. Boşluklar çoğu zaman bir sonraki kelimenin tokenına dahil edilir; sayılar, kodlar ve URL'ler ise beklenmedik yerlerden parçalanabilir.
Bölünmenin nasıl olacağı tamamen kullanılan tokenizer'a bağlıdır. Aşağıdaki örnek yalnızca fikri göstermek içindir; gerçek bir tokenizer aynı kelimeyi farklı parçalara ayırabilir:
"Kitaplarımızdan"  →  "Kit" | "ap" | "lar" | "ımız" | "dan"   (5 token, temsilî)
"from our books"   →  "from" | " our" | " books"            (3 token, temsilî)
Model her adımda bir sonraki tokenı tahmin ederek cevap üretir. Bu yüzden cevap uzunluğu, üretim süresi ve maliyet de token sayısıyla orantılıdır.
Tokenizer nasıl çalışır?
Bugünkü modellerin çoğu, BPE (byte pair encoding) ailesinden alt kelime tokenizer'ları kullanır. Fikir basittir: eğitim metinlerinde en sık yan yana gelen karakter veya bayt çiftleri adım adım birleştirilerek bir sözlük oluşturulur. Sonuçta çok sık görülen dizeler tek token olur, nadir olanlar daha küçük parçalardan kurulur. OpenAI'nin açık kaynak tiktoken kütüphanesinin belgeleri bu yaklaşımın özelliklerini sayar: işlem tersine çevrilebilir, eğitimde hiç görülmemiş metinlerde de çalışır ve metni bayt dizisinden daha kısa bir token dizisine sıkıştırır. Aynı belgeye göre pratikte bir token ortalama 4 bayta karşılık gelir; bu ortalama İngilizce ağırlıklı metinler için geçerlidir.
Her model ailesinin sözlüğü farklıdır. Bir modelde 1.000 token tutan bir metin başka bir modelde belirgin biçimde farklı bir sayı verebilir; token sayıları modeller arasında taşınamaz.
Türkçe neden daha fazla token harcar?
Bu konuda dikkatli konuşmak gerekir, çünkü fark modele göre değişir. Yine de genel eğilimi açıklayan üç neden vardır:
- Eklemeli yapı: Türkçede bir kök onlarca farklı çekimli biçimde görünür. Tokenizer sözlüğü bu biçimlerin her birini tek parça olarak içeremez; kelime kök ve ek parçalarına bölünür.
- Eğitim verisindeki oran: Tokenizer sözlükleri, İngilizcenin genellikle ağır bastığı metinlerden öğrenilir. Sık görülen İngilizce kelimeler tek token olurken Türkçe karşılıkları daha fazla parçaya ayrılabilir.
- Bayt sayısı: ç, ğ, ı, ö, ş, ü harfleri UTF-8'de 2 bayt yer kaplar. Bayt tabanlı tokenizer'larda bu da aynı uzunluktaki metnin daha fazla ham birim içermesi demektir.
Sonuç olarak aynı içeriğin Türkçesi çoğu modelde İngilizcesinden daha fazla token tutar; daha büyük sözlüklere sahip yeni tokenizer'larda bu fark daralabilir. Kesin oran için tahmin yürütmek yerine kendi metinlerinizi sağlayıcının token sayma aracıyla ölçmek gerekir.
Tokenlar neyi belirler?
| Konu | Token ile ilişkisi |
|---|---|
| Bağlam penceresi | Modelin bir istekte dikkate alabileceği toplam token sayısı |
| Çıktı sınırı | Bir cevapta üretilebilecek en fazla token (API'lerde ayrı bir parametre) |
| Ücretlendirme | API'lerde girdi ve çıktı tokenları genellikle ayrı fiyatlandırılır |
| Gecikme | Cevap token token üretildiğinden, uzun çıktı daha uzun sürer |
| Embedding girdisi | Embedding modellerinin de token cinsinden bir girdi sınırı vardır |
Pratikte sık yapılan hatalar
Bütçe ve kapasite hesabını kelime sayısıyla yapmak en yaygın hatadır. İngilizce için verilen “şu kadar kelime yaklaşık şu kadar token eder” türü kuralları Türkçeye doğrudan uygulamak, maliyeti ve bağlam ihtiyacını olduğundan düşük gösterir. Belgeleri bölerken de parça boyutunu karakter veya kelime yerine token cinsinden belirlemek, modelin sınırlarına uyumu kolaylaştırır. Bir de karışıklığa dikkat: buradaki token, oturum açmada kullanılan erişim tokenlarıyla ya da tasarım sistemlerindeki design token kavramıyla aynı şey değildir.