

Çıkarım (Inference) Nedir?
Kısa tanım
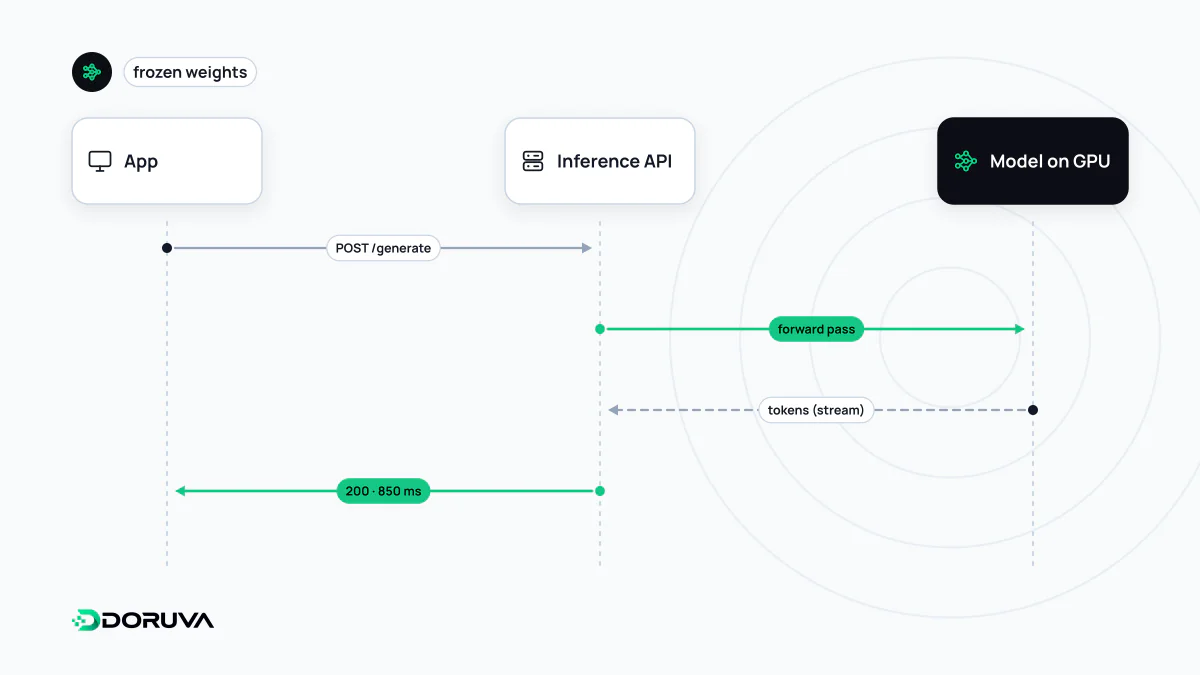
Çıkarım (inference), eğitimi tamamlanmış bir yapay zekâ modelinin yeni bir girdiyi işleyip çıktı üretmesidir. Büyük dil modellerinde bu, prompt'un okunması ve cevabın token token üretilmesi anlamına gelir. Eğitim modelin ağırlıklarını değiştirir; çıkarım ise sabit ağırlıklarla çalışır ve her istekte yeniden yapılır. Gecikme, istek başına maliyet ve kapasite planlaması büyük ölçüde bu aşamada belirlenir.
Diğer adları: inference, model inference, LLM inference, çıkarsama, model çalıştırma
Eğitim ve çıkarım: iki ayrı evre
Bir dil modelinin hayatı iki evreden oluşur. Eğitimde model büyük bir veri kümesi üzerinde defalarca çalıştırılır ve her adımda milyarlarca ağırlığı biraz güncellenir. Çıkarımda ise ağırlıklar donmuştur; model yalnızca kendisine verilen girdiyi işler ve bir çıktı üretir. Eğitim bir kez ya da ara sıra yapılan pahalı bir projedir. Çıkarım ise model yayına girdiği andan itibaren her kullanıcı isteğinde tekrarlanan bir işletme maliyetidir.
| Eğitim | Çıkarım | |
|---|---|---|
| Ne değişir? | Modelin ağırlıkları | Hiçbir şey; ağırlıklar sabit kalır |
| Ne sıklıkla? | Model sürümü başına bir kez, ince ayarla ara sıra | Her istekte |
| Kritik ölçü | Toplam hesaplama ve veri kalitesi | Gecikme, istek başına maliyet, eşzamanlı kapasite |
| Bilgi kaynağı | Eğitim verisi | Eğitimde öğrenilenler ve o anki bağlam |
Birinin ChatGPT'ye, Claude'a ya da şirket içi bir asistana yazdığı her mesaj, arka planda bir çıkarım isteğidir.
Bir isteğin içinden geçmek: prefill ve decode
Bir LLM'e istek gönderildiğinde metin önce token'lara bölünür. Ardından çıkarım iki aşamada ilerler:
- Prefill (ön doldurma): Prompt'taki tüm token'lar paralel olarak işlenir ve dikkat mekanizmasının sonraki adımlarda yeniden kullanacağı ara sonuçlar (KV önbelleği) hazırlanır. Uzun bir prompt bu aşamayı uzatır.
- Decode (üretim): Model cevabı tek seferde değil, token token yazar. Her yeni token, o ana kadar üretilen her şeye bakılarak seçilir; seçimin ne kadar rastgele olacağını sıcaklık parametresi gibi örnekleme ayarları belirler.
Bu yapı, kullanıcının hissettiği iki ayrı bekleme süresini açıklar. İlk token'ın gelmesine kadar geçen süre (time to first token) büyük ölçüde prefill'e, metnin akış hızı ise decode'a bağlıdır. 3.000 token'lık bir belgeyi özetleyen istek, ilk kelimeyi göstermeden önce belgenin tamamını işlemek zorundadır. Kısa bir soruya uzun cevap veren istek ise hızlı başlar ama uzun süre akar. Cevabı akış (streaming) halinde göstermek toplam süreyi kısaltmaz; kullanıcının boş ekrana baktığı süreyi kısaltır.
Maliyeti ve hızı ne belirler?
- Token sayısı: API'ler genellikle giriş ve çıkış token'larını ayrı ayrı fiyatlandırır. Gereğinden uzun sistem talimatları ve her istekte yeniden gönderilen belgeler faturaya doğrudan yansır.
- Model boyutu: Büyük modeller her token için daha fazla hesaplama yapar. Basit sınıflandırma ya da veri çıkarma işleri için küçük bir model çoğu zaman yeterlidir.
- Bağlam uzunluğu: bağlam penceresi doldukça hem bellek ihtiyacı hem de prefill süresi artar.
- Toplu işleme ve önbellek: Sağlayıcılar aynı anda gelen istekleri birlikte işleyerek donanımı verimli kullanır; bazı API'ler tekrar eden prompt başlangıçlarını önbelleğe alarak maliyeti düşürür.
Modeli kendi sunucusunda çalıştıran ekiplerin bir kaldıracı daha vardır: ağırlıkları daha düşük hassasiyetle saklayan nicemleme (quantization) bellek ve maliyeti azaltır. Karşılığında kalitede bir kayıp olabilir; bu kayıp varsayılmamalı, kendi görevlerinizle ölçülmelidir.
Model çıkarım anında ne bilir?
Çıkarım sırasında modelin elinde iki bilgi kaynağı vardır: eğitimde ağırlıklarına yerleşmiş parametrik bilgi ve o istekle birlikte gelen bağlam. Eğitim verisinin bittiği tarihten sonraki bir gelişmeyi model ancak biri bu bilgiyi bağlama koyarsa bilebilir. RAG sistemleri ve web araması yapan yapay zekâ asistanları tam olarak bunu yapar: soruyla ilgili belgeleri bulur ve çıkarım isteğine ekler.
Bu ayrımın site sahipleri için somut bir sonucu var. Bir yapay zekâ aramasında sayfanızın kaynak gösterilmesi, içeriğinizin eğitim verisinde bulunmasına değil, çoğunlukla çıkarım anında getirilip modele okutulmasına bağlıdır. Eğitim tarayıcılarını engelleyip arama ve kullanıcı isteği botlarına izin vermenin mantığı da buradan gelir.
Kelimenin iki anlamı
"Çıkarım" mantıkta ve istatistikte de kullanılır: istatistiksel çıkarım, bir örneklemden evren hakkında sonuç çıkarmaktır. Yapay zekâ mühendisliğinde terim çok daha somuttur ve modeli çalıştırmak anlamına gelir. Modelin "akıl yürütme" yeteneğiyle de karıştırılmamalıdır. "Çıkarım maliyeti", "çıkarım sunucusu" ya da "çıkarım gecikmesi" dendiğinde kastedilen her zaman bu operasyonel anlamdır.