

Doğal Dil İşleme (NLP) Nedir?
Kısa tanım
Doğal dil işleme (NLP), bilgisayarların insan dilindeki metni ve konuşmayı çözümlemesini, anlamlandırmasını ve üretmesini sağlayan yapay zekâ ve dilbilim alanıdır. Metin sınıflandırma, duygu analizi, varlık tanıma, makine çevirisi, özetleme ve soru yanıtlama tipik NLP görevleridir. Kural tabanlı sistemlerle başlayan alan, bugün büyük ölçüde makine öğrenmesine ve Transformer tabanlı dil modellerine dayanır.
Diğer adları: NLP, natural language processing, doğal dil işlemesi, NLU, hesaplamalı dilbilim
Kurallardan dil modellerine
NLP'nin ilk dönemi, dil bilgisi kurallarının ve sözlüklerin elle yazıldığı sistemlerle geçti. Bu sistemler dar alanlarda iyi çalışıyor, ama dilin esnekliği karşısında hızla kırılıyordu. Ardından istatistiksel yöntemler geldi: kelime sıklıkları, n-gram olasılıkları ve TF-IDF gibi ağırlıklandırmalar. Sonraki adım, kelimeleri anlam yakınlığını taşıyan vektörlerle temsil etmek oldu. Bugünkü dönemi ise geniş metinlerle ön eğitilmiş, Transformer tabanlı modeller belirliyor. Bu modeller birçok görevi ayrı ayrı tasarlanmış sistemler yerine tek bir genel yetenekle çözebiliyor.
Bir metin hangi adımlardan geçer?
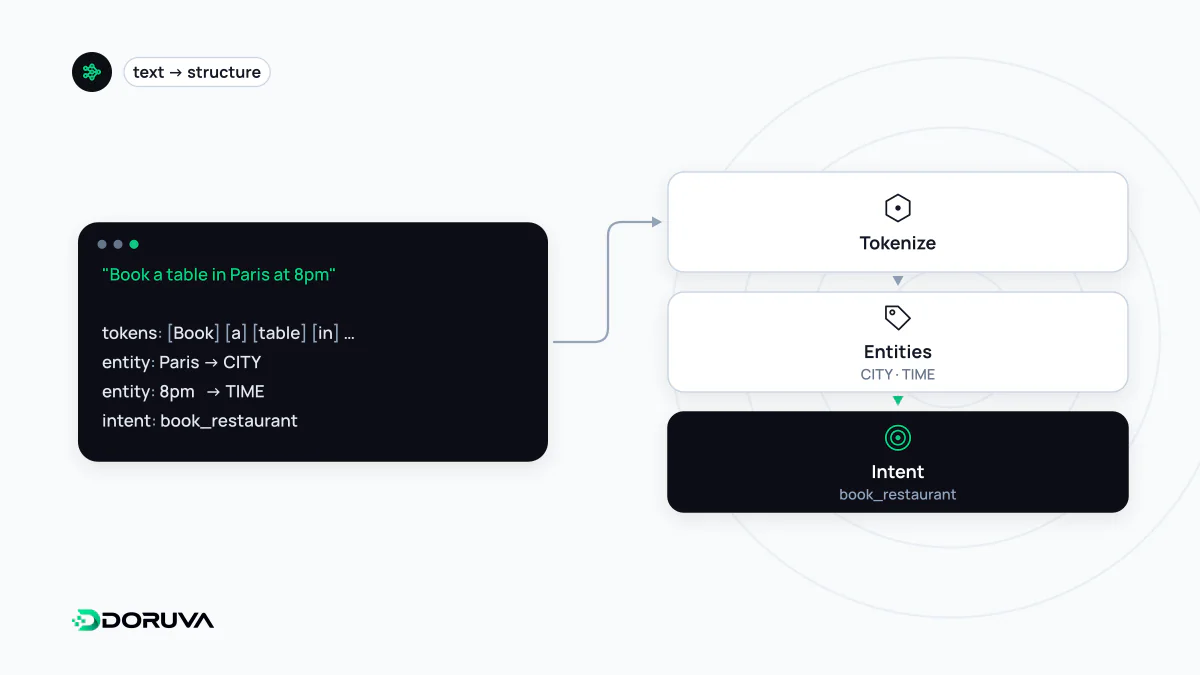
Modern dil modelleri bu adımların çoğunu kendi içinde örtük olarak yapsa da klasik bir NLP hattını bilmek, nerede hata çıkabileceğini anlamaya yardım eder:
- Parçalama (tokenization): Metin kelime, alt kelime veya karakter düzeyinde birimlere ayrılır.
- Normalleştirme: Büyük-küçük harf, aksan ve yazım farklılıkları tek biçime getirilir.
- Biçimbilimsel çözümleme: Kelimenin kökü ve ekleri ayrılır.
- Sözcük türü etiketleme ve sözdizimi: Hangi kelimenin isim, fiil ya da sıfat olduğu, cümlede kimin neyi yaptığı belirlenir.
- Anlam katmanı: Varlık tanıma, ilişki çıkarımı, duygu analizi gibi görevler bu temel üzerine kurulur.
Türkçe neden ayrı bir dikkat ister?
Türkçe eklemeli bir dildir. “Evlerimizden” tek bir kelime gibi görünür, ama içinde kök (ev), çoğul eki, iyelik eki ve ayrılma hâli bulunur. İngilizce için tasarlanmış basit kelime sayma yöntemleri bu yüzden Türkçede aynı kökün yüzlerce farklı biçimini ayrı kelimeler olarak görür. Alt kelime tabanlı token'lama bu sorunu kısmen hafifletir.
Normalleştirme de tuzaklıdır. Türkçede noktalı ve noktasız i ayrı harflerdir; dile duyarsız bir küçültme işlemi “IŞIK” kelimesini yanlış biçime çevirir:
"IŞIK".toLowerCase()             // "işik"  (yanlış)
"IŞIK".toLocaleLowerCase("tr")   // "ışık"  (doğru)
Arama kutusundan form doğrulamaya kadar Türkçe metin işleyen her yazılımda bu fark, eşleşmeyen kayıtlar ve bulunamayan ürünler olarak geri döner.
Arama motorları ve yapay zekâ asistanları dili nasıl kullanır?
Arama motorları NLP'yi, sorgudaki kelimeleri birebir eşleştirmenin ötesine geçmek için kullanır: eş anlamlıları tanımak, yazım hatalarını düzeltmek, sorgunun bilgi mi yoksa satın alma mı amaçladığını, yani arama niyetini çıkarmak ve sayfadaki hangi pasajın soruyu cevapladığını belirlemek. Anlamsal arama bu yaklaşımın vektör temsillerine dayanan biçimidir. Yapay zekâ asistanları ise aynı yetenekleri cevap üretmeye taşır.
İçerik üretenler için sonuç basittir: Dili doğal ve açık kullanan, kavramları tanımlayan, özneyi ve nesneyi belirsiz bırakmayan metinler hem insanlar hem de makineler tarafından daha doğru çözümlenir. Anahtar kelimeyi mekanik olarak tekrar etmek, modern dil işleme karşısında artık bir avantaj sağlamaz.
NLP, NLU ve LLM aynı şey mi?
Hayır. NLP şemsiye alandır. Doğal dil anlama (NLU), metnin anlamını çıkarmaya; doğal dil üretimi (NLG) ise metin üretmeye odaklanan alt alanlardır. Büyük dil modelleri bu iki işi aynı anda yapabilen güçlü bir araç ailesidir, ama NLP'nin tamamı değildir. Sınırlı bütçeli bir sınıflandırma ya da varlık çıkarma işi için küçük, özel eğitilmiş bir model hâlâ daha hızlı, ucuz ve öngörülebilir olabilir.