

Adlandırılmış Varlık Tanıma (NER) Nedir?
Kısa tanım
Adlandırılmış varlık tanıma (NER), bir metindeki kişi, kurum, yer, tarih, ürün ve para tutarı gibi özel adlandırılmış ifadeleri bulup önceden tanımlı türlere ayıran doğal dil işleme görevidir. Örneğin “Ayşe Yılmaz mart ayında Ankara'daki ofisi açtı” cümlesinde Ayşe Yılmaz kişi, mart tarih, Ankara yer olarak etiketlenir. NER, arama motorlarının ve yapay zekâ sistemlerinin metni varlıklar üzerinden anlamasının ilk adımıdır.
Diğer adları: NER, named entity recognition, varlık çıkarımı, entity extraction, varlık tanıma
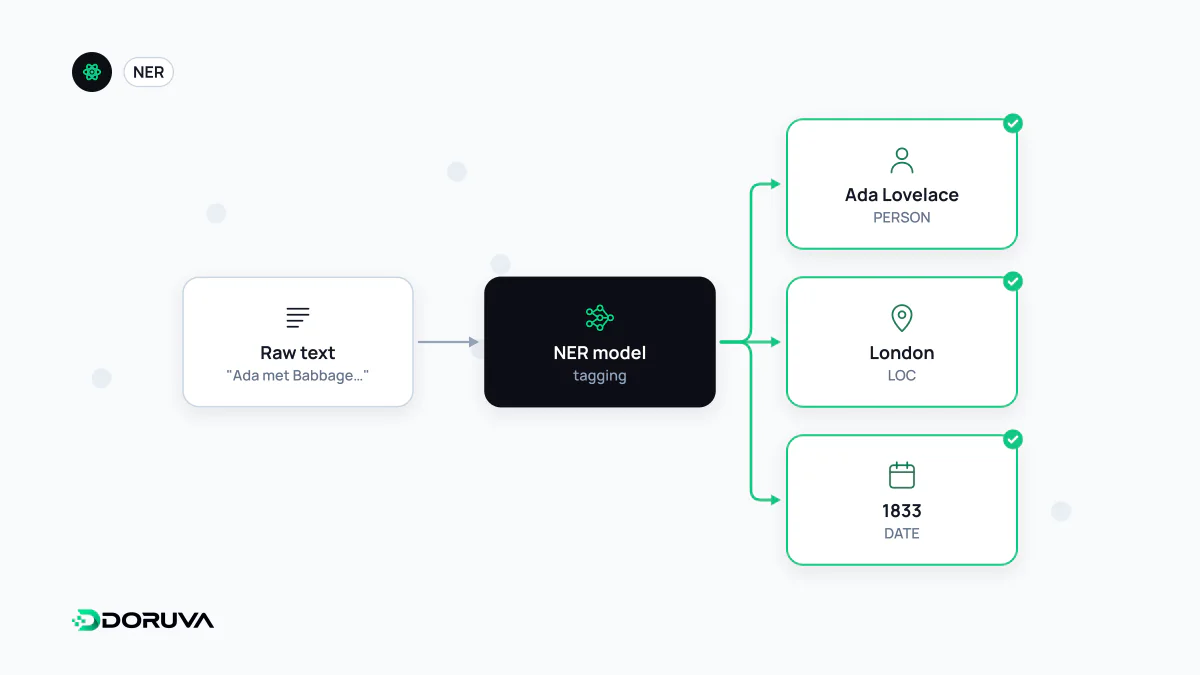
Etiketlenmiş bir cümle neye benzer?
NER modelleri çoğunlukla her token'a bir etiket atar. Yaygın BIO şemasında B- bir varlığın başladığını, I- devam ettiğini, O ise token'ın bir varlığa ait olmadığını gösterir:
Ayşe         B-PER
Yılmaz       I-PER
mart         B-DATE
ayında       O
Ankara'daki  B-LOC
ofisi        O
açtı         O
Türkçede özel adlara gelen ekleri kesme işaretiyle ayırma kuralı modellerin işini kolaylaştırır; “Ankara'daki” kelimesinde kökün nerede bittiği bellidir. Kural uygulanmadığında (“Ankaradaki”) ya da kurum adı küçük harfle ve ekle birleşik yazıldığında hata oranı artar.
Etiket kümesi göreve göre değişir. Genel amaçlı modeller kişi, kurum, yer ve tarih gibi türlerle yetinir; bir e-ticaret modeli marka, ürün ve beden, bir hukuk modeli mahkeme ve kanun numarası gibi alana özel türler tanıyacak şekilde eğitilebilir.
Tanıma, bağlama ve önem: üç ayrı iş
NER yalnızca “bu metin parçası bir kurum adıdır” der. “Hangi kurum?” sorusunu cevaplamaz. “Mercan” bir kişi adı da olabilir, bir şirket de. Tanınan ifadeyi bir bilgi tabanındaki tek bir kayda bağlamak ayrı bir adımdır ve varlık ayrıştırma (entity linking) olarak ele alınır. Bağlanan varlıkların metin içindeki merkezîliği ise varlık belirginliği ile ölçülür.
Bu üç adımın birlikte nasıl çıktı verdiğini görmek için Google Cloud Natural Language API'nin varlık analizi iyi bir örnektir: Her varlık için ad, tür (PERSON, LOCATION, ORGANIZATION gibi), metindeki geçişler, bir önem puanı (salience) ve tanınan varlıklarda Knowledge Graph kimliği ile Wikipedia adresi gibi meta veriler döner. Bu, ticari bir API'nin çıktısıdır; Google Arama'nın sayfaları tam olarak böyle işlediği anlamına gelmez, ama genel mantığı somutlaştırır.
NER nasıl yapılır?
- Kural ve sözlük (gazetteer) tabanlı: Bilinen adlar listesi ve düzenli ifadeler. Vergi numarası, IBAN veya sipariş kodu gibi biçimi belli varlıklarda hâlâ en güvenilir yoldur.
- İstatistiksel ve sinir ağı modelleri: Etiketli metinlerle eğitilen modeller, özellikle Transformer tabanlı encoder'lar, bağlamdan yararlanarak daha önce görmedikleri adları da tanıyabilir.
- Büyük dil modelleri: Bir LLM'e metni verip varlıkları JSON olarak döndürmesi istenebilir. Esnektir ve yeni türlere hızla uyar; ama daha yavaş, daha pahalı ve her çağrıda birebir aynı sonucu vermeyebilir.
Kişisel veri içeren metinlerde NER, maskeleme ve anonimleştirme için de kullanılır. Bu durumda kaçırılan her ad bir veri sızıntısı riski olduğu için yalnızca modelin ortalama başarısına değil, hangi tür adları kaçırdığına bakmak gerekir.
İçerik yazarken neye dikkat etmeli?
Arama motorları ve yapay zekâ sistemleri bir sayfayı, içindeki varlıklar ve bunlar arasındaki ilişkiler üzerinden de anlar. Varlıkların doğru tanınmasına yardım eden alışkanlıklar şunlardır:
- Bir kişiyi, kurumu veya ürünü ilk geçtiği yerde tam adıyla yazmak; sonrasında kısaltmaya geçmek.
- Aynı varlık için sayfa ve site genelinde tek bir yazım kullanmak.
- Belirsiz adları bağlamla desteklemek: şehir, sektör, görev unvanı.
- Kurum, kişi ve ürün bilgilerini yapılandırılmış veri ile açıkça işaretlemek. Bu, metinden çıkarım yapma ihtiyacını azaltır ama tek başına bir garantiye dönüşmez.