

Yeniden Sıralama (Reranking) Nedir?
Kısa tanım
Yeniden sıralama (reranking), ilk getirme aşamasının bulduğu aday belge veya pasajların daha yavaş ama daha isabetli bir modelle yeniden puanlanıp sıralanmasıdır. Bu iş için en yaygın model türü, sorguyu ve pasajı birlikte okuyan cross-encoder'lardır. Amaç, dil modeline ya da kullanıcıya gösterilecek ilk birkaç sonucun gerçekten en alakalı olanlar olmasını sağlamaktır.
Diğer adları: reranking, re-ranking, reranker, cross-encoder reranking, yeniden sıralayıcı
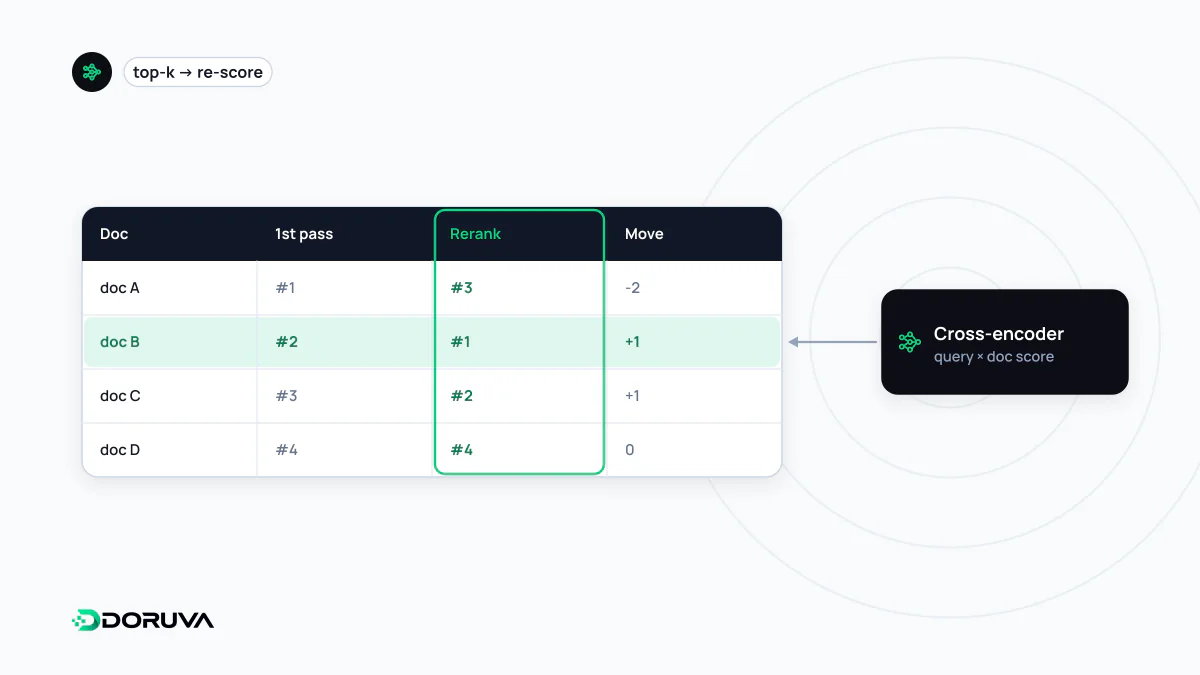
İki aşamalı aramada ikinci adım
Büyük bir koleksiyonda arama yapan sistemler hız ile isabet arasında bir uzlaşma kurar. İlk aşamada hızlı bir getirici, milyonlarca belge arasından örneğin 100 aday seçer. İkinci aşamada yeniden sıralayıcı (reranker) yalnızca bu 100 adayı sorguyla birlikte tek tek okuyarak puanlar ve en iyi 5–10 tanesini öne alır. Yavaş ama hassas bir modeli bütün koleksiyona uygulamak mümkün olmadığından, onu yalnızca kısa listeye uygulamak pratik bir çözümdür.
Yeniden sıralayıcı, ilk aşamanın kaçırdığı bir belgeyi bulamaz; yalnızca önüne konanları yeniden düzenler. Bu yüzden iki aşama birbirinin alternatifi değil, tamamlayıcısıdır.
Bi-encoder ile cross-encoder arasındaki fark
| Bi-encoder (ilk aşama) | Cross-encoder (yeniden sıralama) | |
|---|---|---|
| Girdi | Sorgu ve belge ayrı ayrı kodlanır | Sorgu ve pasaj tek bir girdi olarak birlikte okunur |
| Çıktı | İki embedding; benzerlik sonradan hesaplanır | Doğrudan tek bir alaka puanı |
| Önceden hesaplama | Belge vektörleri dizinleme sırasında bir kez üretilir | Mümkün değil; her sorgu-pasaj çifti için model yeniden çalışır |
| Maliyet | Milyonlarca belgede milisaniyeler | Aday sayısıyla doğru orantılı |
| İsabet | Konu benzerliğini iyi yakalar, ince ayrımları kaçırabilir | Sorgu ile pasaj arasındaki kelime ilişkilerini doğrudan görür |
Cross-encoder'ın üstünlüğü, transformer dikkat mekanizmasının sorgudaki her kelimeyi pasajdaki her kelimeyle doğrudan ilişkilendirebilmesinden gelir. "Kedimi hangi aralıklarla aşılatmalıyım?" sorgusunda bir bi-encoder, köpek aşı takvimini anlatan bir pasajı da yüksek puanlayabilir; iki metin de evcil hayvan aşısıyla ilgilidir. Cross-encoder ise sorgudaki "kedi" ile pasajdaki "köpek" arasındaki uyumsuzluğu görür ve o pasajı geriye iter.
Diğer yeniden sıralama yaklaşımları
- Dil modeliyle yeniden sıralama: Bir LLM'e sorgu ve aday pasajlar verilip her birini puanlaması (pointwise) ya da listenin tamamını sıralaması (listwise) istenir. Esnektir ama pahalı ve yavaştır; sonuç prompt'un nasıl yazıldığına duyarlıdır.
- Geç etkileşim (late interaction): ColBERT gibi modeller belgeleri kelime düzeyinde vektörler olarak önceden saklar ve sorgu geldiğinde bu vektörleri eşleştirir. Bi-encoder ile cross-encoder arasında bir orta yoldur.
- Öğrenmeli sıralama (learning to rank): Klasik arama motorlarında metin alakası, tazelik, tıklama verisi gibi birçok özellik bir sıralama modeliyle birleştirilir.
Gecikme bütçesi ve aday sayısı
Cross-encoder'ın maliyeti puanlanacak aday sayısıyla birlikte büyür: 100 aday, modelin 100 kez çalışması demektir. Pratikte iki ayar dengelenir. Yeniden sıralamaya gönderilen aday sayısı arttıkça ilk aşamada geride kalan iyi sonuçların kurtarılma şansı yükselir, ama gecikme uzar. Yeniden sıralamadan sonra dil modeline verilen pasaj sayısı arttıkça cevap için daha fazla kanıt olur, ama bağlam şişer ve maliyet artar. Doğru değerler, gerçek sorgularla ölçülen isabet ve gecikme hedeflerine göre seçilir. Hibrit arama kullanan sistemlerde yeniden sıralayıcı genellikle iki sonuç listesi birleştirildikten sonra devreye girer.
İçerik açısından ne anlama geliyor?
Yeniden sıralayıcı bir pasajı sorguyla yan yana okur. Konuyla genel olarak ilgili ama soruyu doğrudan cevaplamayan bir paragraf bu aşamada geriler; sorudaki varlıkları ve aralarındaki ilişkiyi açıkça adlandıran bir paragraf öne çıkar. "Fiyatlarımız rekabetçidir" cümlesi, fiyat soran bir sorguyla "Kurumsal paketin ücreti kullanıcı başına aylık olarak belirlenir ve yıllık ödemede indirim uygulanır" cümlesi kadar iyi eşleşmez. Pasajların nasıl aday haline geldiği pasaj getirme, sıralamanın arkasındaki puan mantığı ise alaka puanlaması maddesinde anlatılıyor.