

Alaka Puanlaması (Relevance Scoring) Nedir?
Kısa tanım
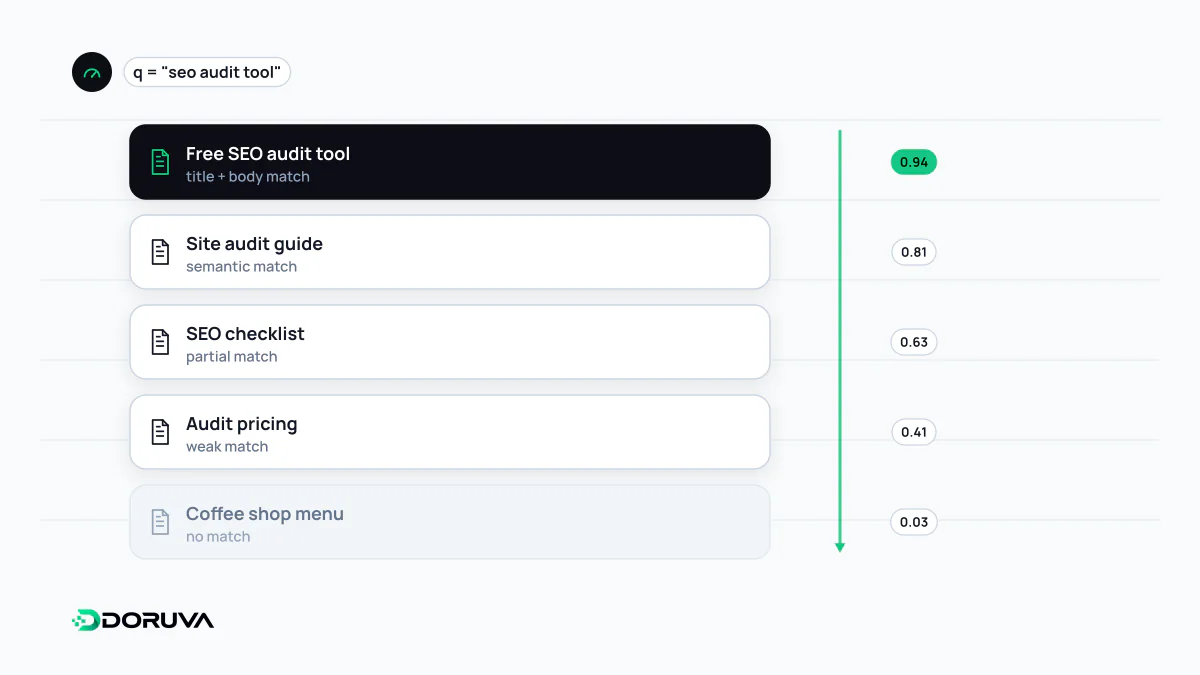
Alaka puanlaması (relevance scoring), bir arama sisteminin bir belge ya da pasajın belirli bir sorguyla ne kadar ilgili olduğunu sayısal bir puanla ifade etmesidir; sonuçlar bu puana göre sıralanır. Klasik yöntemler TF-IDF ve BM25 gibi kelime istatistiklerine, modern yöntemler embedding benzerliğine ve cross-encoder modellere dayanır. Büyük arama motorları bu puanları başka birçok sinyalle birlikte kullanır.
Diğer adları: relevance scoring, alaka skoru, BM25, TF-IDF, relevance score
Puan neyi ölçer, neyi ölçmez?
Alaka puanı tek bir soruya verilen cevaptır: "Bu metin bu sorguyla ne kadar ilgili?" Kalite, güvenilirlik ya da güncellik ölçüsü değildir; bunlar ayrı sinyallerdir. Puan ayrıca görelidir. Bir sorguda 12,4 alan belgeyi başka bir sorguda 8,1 alan belgeyle karşılaştırmak anlamsızdır; anlamlı olan, aynı sorgu için adayların birbirine göre sırasıdır. Büyük arama motorları alaka puanını tek başına kullanmaz. Google'ın sıralama sistemleri rehberi, dili ve niyeti anlamaya yönelik sistemlerin yanında güvenilir bilgi, özgün içerik ve tazelik gibi konulara odaklanan sistemleri de listeler.
TF-IDF: sıklık çarpı nadirlik
Sözcüksel alaka puanlamasının klasik başlangıç noktası TF-IDF'tir ve iki bileşenden oluşur:
- TF (terim sıklığı): Sorgudaki kelimenin belgede kaç kez geçtiği. Sık geçen kelime, belgenin o konuyla ilgili olduğuna işaret eder.
- IDF (ters belge sıklığı): Kelimenin koleksiyonda ne kadar nadir olduğu; çoğunlukla log(N / df) olarak hesaplanır. N toplam belge sayısı, df kelimenin geçtiği belge sayısıdır.
10.000 belgelik bir koleksiyonda "ve" kelimesi her belgede geçiyorsa IDF'si ln(10.000 / 10.000) = 0 olur; kelime hiçbir belgeyi ötekinden ayırmaz. "Kanonik" kelimesi yalnızca 50 belgede geçiyorsa IDF'si ln(200) ≈ 5,3 olur ve eşleşmesi puana güçlü katkı yapar. "Kanonik URL ve yönlendirme" sorgusunda asıl işi nadir kelimeler görür.
BM25: sıklığa tavan koymak
TF-IDF'in zayıf noktası, terim sıklığının etkisinin sınırsız artmasıdır: bir kelimeyi 50 kez tekrar eden belge, 5 kez kullanan belgeden on kat daha "ilgili" görünür. BM25 bu sorunu iki parametreyle çözer. Formülün yaygın biçimi:
puan(D, Q) = Σ IDF(q) · [ f(q,D) · (k1 + 1) ] / [ f(q,D) + k1 · (1 − b + b · |D| / ort_uzunluk) ]Burada f(q, D) sorgu terimi q'nun D belgesinde kaç kez geçtiği, |D| belgenin uzunluğu, ort_uzunluk koleksiyondaki ortalama belge uzunluğudur. k1 sıklığın ne kadar çabuk doyuma ulaşacağını, b uzunluk düzeltmesinin gücünü belirler. Elasticsearch, BM25'i varsayılan benzerlik fonksiyonu olarak kullanır ve varsayılan değerleri k1 = 1,2 ile b = 0,75'tir.
Bu değerlerle, ortalama uzunluktaki bir belgede sıklık bileşeni şöyle davranır:
| Terimin belgede geçme sayısı | Sıklık bileşeni |
|---|---|
| 1 | 1,00 |
| 3 | 1,57 |
| 10 | 1,96 |
| Çok büyük | 2,20'ye (k1 + 1) yaklaşır |
Bir kelimeyi on kez kullanmak, bir kez kullanmanın iki katı bile puan getirmez. Uzunluk düzeltmesi de aynı yönde çalışır: ortalamanın iki katı uzunluktaki bir belgede tek bir eşleşmenin katkısı 1,00'dan yaklaşık 0,71'e iner. Anahtar kelime doldurmanın en basit sözcüksel modellerde bile sınırlı getiri sağlamasının matematiksel nedeni budur.
Anlamsal puanlar
Kelime eşleşmesi, aynı anlamı farklı kelimelerle anlatan metni kaçırır. Bu boşluğu dolduran yöntemler puanı başka yollarla üretir:
- Embedding benzerliği: Sorgu ve belge embedding'lere dönüştürülür; puan, iki vektör arasındaki kosinüs benzerliği gibi bir ölçüdür.
- Cross-encoder puanı: Sorgu ve pasaj bir modele birlikte verilir, model doğrudan bir alaka puanı üretir. Daha isabetli ama daha pahalı olduğu için çoğunlukla yeniden sıralama aşamasında kullanılır.
- Dil modeli değerlendirmesi: Bir LLM'den pasajın soruyu ne ölçüde cevapladığını puanlaması istenir.
Bu puanların ölçekleri birbirine benzemez: BM25'in üst sınırı yoktur, kosinüs benzerliği dar bir aralıkta kalır. Farklı yöntemlerin sonuç listelerini birleştirmenin yolları hibrit arama maddesinde anlatılıyor.
SEO ve GEO için çıkarılacak dersler
Alaka puanlamasının mantığı içerik üretimi için iki sade sonuç verir. Birincisi, bir kelimeyi tekrarlamanın getirisi hızla azalır; konunun gerektirdiği terimleri, varlıkları ve alt soruları kapsamak daha çok iş görür. İkincisi, anlamsal puanlama kullanıcının arama niyetine cevap veren metni ödüllendirir; doğru kelimeleri içerip soruyu cevaplamayan bir paragraf, yeniden sıralama gibi aşamalarda geriler. Hiçbir puanlama yöntemi tek başına sıralama garantisi vermez. Yüksek alaka, görünür olmanın ön koşullarından yalnızca biridir; diğer sinyallerle ilişkisi için sıralama faktörü maddesine bakabilirsiniz.