

Vektör Arama (Vector Search) Nedir?
Kısa tanım
Vektör arama (vector search), sayısal vektörler olarak saklanan kayıtlar arasından bir sorgu vektörüne belirli bir uzaklık ölçüsüne göre en yakın olanları bulan arama yöntemidir. Kayıtlar genellikle metin, görsel veya ürünlerin embedding'leridir. Büyük koleksiyonlarda her vektörü tek tek karşılaştırmak yavaş olduğundan HNSW veya IVF gibi yaklaşık en yakın komşu (ANN) dizinleri kullanılır; bu dizinler biraz isabetten feragat ederek büyük hız kazandırır.
Diğer adları: vector search, vektör benzerlik araması, en yakın komşu araması, ANN araması, k-NN araması
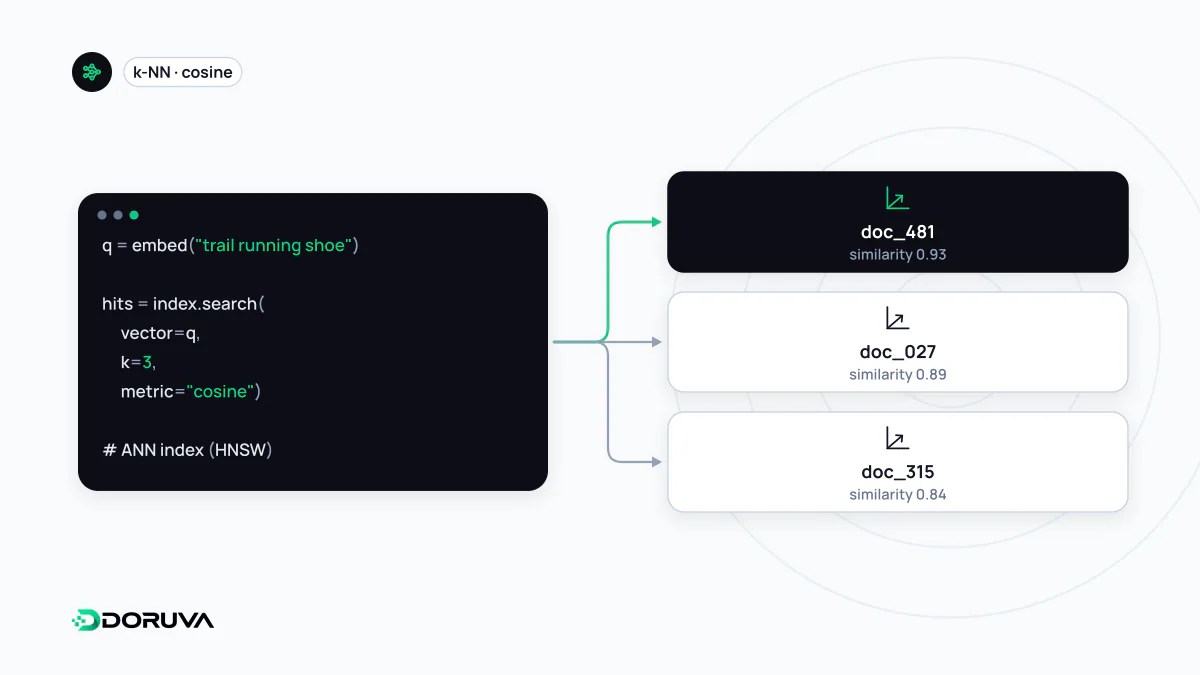
Problem: en yakın k vektörü bulmak
Anlamsal arama bir hedeftir: anlamca yakın içeriği bulmak. Vektör arama ise bu hedefe ulaşmak için kullanılan mekanizmadır ve sorusu daha dardır: d boyutlu N vektör arasında, sorgu vektörüne en yakın k tanesi hangileri? Vektörler çoğunlukla bir modelin ürettiği embedding'lerdir; vektör arama bunların nereden geldiğiyle ilgilenmez, yalnızca geometriye bakar.
En basit çözüm kesin aramadır (flat veya brute force): sorgu her vektörle karşılaştırılır ve en yakınlar seçilir. Sonuç kusursuzdur ama maliyet N × d ile büyür. Birkaç on bin kayıtta bu genellikle yeterince hızlıdır. On milyonlarca kayıtta ise her sorguda bütün koleksiyonu taramak kabul edilemez; burada yaklaşık en yakın komşu (ANN) dizinleri devreye girer. ANN, gerçek en yakın komşuların bir kısmını kaçırma pahasına aramayı çok daha hızlı yapar. Bu kayıp recall ile ölçülür: kesin aramanın bulduğu ilk 10 sonucun kaçını ANN de buldu?
Uzaklık ölçüsünü seçmek
| Ölçü | Ne ölçer? | Not |
|---|---|---|
| Öklid (L2) uzaklığı | İki nokta arasındaki düz çizgi mesafesi | Küçük değer daha yakın demektir |
| İç çarpım (dot product) | Yön ve büyüklüğün birleşik etkisi | Büyük değer daha benzer demektir |
| Kosinüs uzaklığı | Yalnızca yön farkı (1 − kosinüs benzerliği) | Vektör uzunluğundan etkilenmez |
Pratik kural: embedding modelinin belgelerinde önerilen ölçüyü kullanın. Vektörler birim uzunluğa normalize edilmişse kosinüs ve iç çarpım aynı sıralamayı verir; bu durumda iç çarpım hesaplaması biraz daha ucuzdur. Dizini hangi ölçüyle kurduysanız sorguyu da aynı ölçüyle yapmalısınız.
İki yaygın ANN dizini: HNSW ve IVF
HNSW (Hierarchical Navigable Small World), vektörleri katmanlı bir komşuluk grafiğine yerleştirir. Üst katmanlarda az sayıda düğüm ve uzun “otoyol” bağlantıları, alt katmanlarda yoğun ve kısa bağlantılar bulunur. Arama en üstten başlar, her katmanda sorguya yaklaşan komşulara atlayarak aşağı iner. Sorgu performansı ve recall açısından güçlüdür; karşılığında daha fazla bellek kullanır ve kurulması daha uzun sürer.
IVF (Inverted File) ise vektörleri önce kümelere ayırır ve her vektörü en yakın küme merkezinin listesine koyar. Sorgu geldiğinde yalnızca en yakın birkaç kümenin listeleri taranır. Daha hızlı kurulur ve daha az bellek ister, ama kümeleri oluşturmak için önceden veri gerekir ve taranan küme sayısı az tutulursa recall düşer. Her iki yöntem, vektörleri sıkıştıran niceleme (quantization) teknikleriyle birleştirilerek bellek maliyeti daha da azaltılabilir.
Örnek: PostgreSQL üzerinde pgvector
pgvector eklentisi PostgreSQL'e vektör sütunu, uzaklık operatörleri (<-> L2, <#> negatif iç çarpım, <=> kosinüs uzaklığı) ve HNSW ile IVFFlat dizinleri ekler:
CREATE EXTENSION vector;

CREATE TABLE pasajlar (
  id        bigserial PRIMARY KEY,
  url       text,
  metin     text,
  embedding vector(768)
);

CREATE INDEX ON pasajlar USING hnsw (embedding vector_cosine_ops);

-- $1: sorgunun aynı modelle üretilmiş embedding'i
SELECT url, metin
FROM pasajlar
ORDER BY embedding <=> $1
LIMIT 5;
Boyut (burada 768) kullandığınız modele göre belirlenir. Dizin olmadan aynı sorgu kesin arama yapar; dizin eklendiğinde sonuçlar hızlanır ama birebir aynı olmayabilir.
Ayar ve ölçüm
- Recall'u ölçün: Örnek sorgular için kesin aramanın sonucunu referans alın, ANN sonuçlarını onunla karşılaştırın.
- Arama parametrelerini ayarlayın: HNSW'de aday listesinin genişliği (pgvector'da
hnsw.ef_search), IVF'de taranan liste sayısı (ivfflat.probes) hız ile recall arasındaki dengeyi belirler. - Filtrelere dikkat: Dil, tarih veya müşteri gibi bir filtre ANN aramasından sonra uygulanırsa, istenen k sonuçtan azı dönebilir. Filtreli sorguları ayrıca test edin.
- Gerekmiyorsa dizin kurmayın: Küçük koleksiyonlarda kesin arama hem daha basit hem de kusursuzdur.
Bu işlemleri ölçekli biçimde, kalıcılık ve meta verilerle birlikte sunan sistemlere vektör veritabanı denir.