

Vektör Veritabanı Nedir?
Kısa tanım
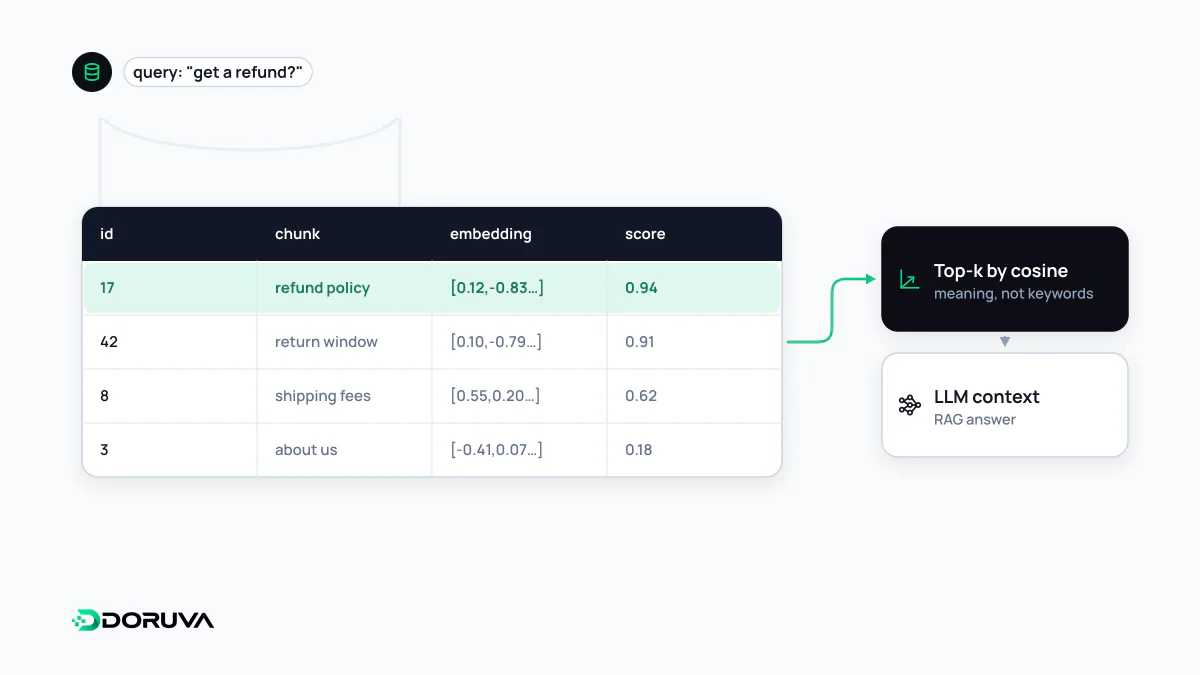
Vektör veritabanı, embedding gibi yüksek boyutlu vektörleri kaynak metin ve meta verileriyle birlikte saklayan ve bunlar üzerinde hızlı benzerlik sorguları çalıştırmak üzere tasarlanmış veri yönetim sistemidir. Yaklaşık en yakın komşu dizinlerinin yanında kalıcılık, güncelleme, filtreleme, erişim kontrolü ve ölçekleme sunar. Ayrı bir ürün olabileceği gibi PostgreSQL için pgvector gibi mevcut bir veritabanının eklentisi de olabilir.
Diğer adları: vector database, vector DB, vektör deposu, vector store
Bir vektör dizininden fazlası
Vektör arama yapan bir kütüphaneyle vektör veritabanı arasındaki fark, ilişkisel bir veritabanıyla bellekteki bir sıralama algoritması arasındaki farka benzer. Kütüphane, vektörleri bellekte bir dizine koyup en yakınları bulur. Veritabanı ise bunun etrafına bir üretim sisteminin ihtiyaç duyduğu her şeyi ekler: diske yazılan kalıcı veri, kayıt ekleme, güncelleme ve silme, meta veri filtreleri, yedekleme, çoğaltma (replication), erişim kontrolü ve büyüyen veriye göre ölçekleme.
Bu nedenle “vektör veritabanı” bir algoritmanın değil, bir ürün kategorisinin adıdır. İçinde çalışan dizin çoğunlukla HNSW veya IVF gibi bilinen yöntemlerden biridir.
Bir kayıtta neler tutulur?
Bir RAG projesinde tipik bir kayıt yalnızca vektörden oluşmaz:
{
  "id": "yardim-iade-03",
  "embedding": [0.021, -0.113, 0.087, ...],
  "metin": "İade talebi teslimattan itibaren 14 gün içinde ...",
  "url": "https://ornek.example/yardim/iade/",
  "baslik": "İade koşulları",
  "dil": "tr",
  "guncelleme": "2026-09-12",
  "musteri_id": "kiraci-42",
  "model": "embedding-modeli-v2"
}
Metin, modelin okuyacağı içeriktir; URL ve başlık cevapta kaynak göstermeyi sağlar; dil ve tarih filtreleme içindir; müşteri kimliği çok kiracılı (multi-tenant) sistemlerde erişimi ayırır; model sürümü ise ileride modeli değiştirdiğinizde hangi kayıtların yeniden hesaplanacağını gösterir. Belgelerin bu kayıtlara nasıl bölündüğü parçalama kararıdır ve getirme kalitesini doğrudan etkiler.
Eklenti mi, ayrı ürün mü?
| Seçenek | Artısı | Dikkat edilecek nokta |
|---|---|---|
| Mevcut veritabanına eklenti (ör. PostgreSQL ve pgvector) | Tek sistem; SQL, join ve transaction ile asıl veriyle birlikte yönetim | Çok büyük vektör hacimlerinde bellek ve ayar ihtiyacı artar |
| Arama motorunun vektör özelliği (ör. Elasticsearch, OpenSearch) | Anahtar kelime aramasıyla aynı yerde; hibrit sorgular kolay | Arama kümesini işletme bilgisi gerekir |
| Ayrı vektör veritabanı (ör. Qdrant, Weaviate, Milvus, Pinecone) | Büyük ölçekli vektör iş yükleri için tasarlanmış, çoğunun yönetilen servisi var | Asıl veriyle senkron tutulması gereken ikinci bir sistem |
Karar genellikle veri hacmine, ekibin hâlihazırda işlettiği sistemlere ve hibrit aramaya ihtiyaç olup olmadığına göre verilir. Birkaç yüz bin pasajlık bir kurumsal bilgi tabanı için mevcut bir PostgreSQL kurulumu çoğu zaman yeterlidir.
Operasyonel tuzaklar
- Model değişikliği: Farklı modellerin vektörleri karşılaştırılamaz. Modeli değiştirmek, bütün koleksiyonu yeniden hesaplamak demektir; bu iş baştan planlanmalıdır.
- Senkronizasyon: Asıl belge silindiği veya değiştiği hâlde vektör kopyası kalırsa sistem eski bilgiyle cevap verir. Silme ve güncelleme olayları vektör tarafına da yansıtılmalıdır.
- Erişim kontrolü: Çok kiracılı bir sistemde her sorgu kiracı filtresiyle çalışmalıdır; aksi hâlde getirme adımı bir müşterinin belgesini başka bir müşterinin cevabına taşıyabilir. Bu bir güvenlik açığıdır, kalite sorunu değil.
- Bellek maliyeti: HNSW dizinleri bellekte tutulduğunda iyi çalışır; vektör sayısı ve boyutu arttıkça donanım maliyeti hızla büyür. Niceleme ve daha küçük boyutlu modeller seçenekler arasındadır.
Ne zaman gerekmez?
Birkaç bin belgelik bir koleksiyon için ayrı bir sistem kurmak çoğu zaman gereksizdir; bellekte kesin arama yeterlidir. Sorun anlam benzerliği değil de ürün kodu veya kimlik numarasıyla birebir eşleşme ise, sıradan bir veritabanı indeksi doğru araçtır. Vektör veritabanı, RAG ve öneri sistemleri gibi anlam benzerliğine dayalı ve ölçeği büyük işler için anlamlıdır.