

Hibrit Arama (Hybrid Search) Nedir?
Kısa tanım
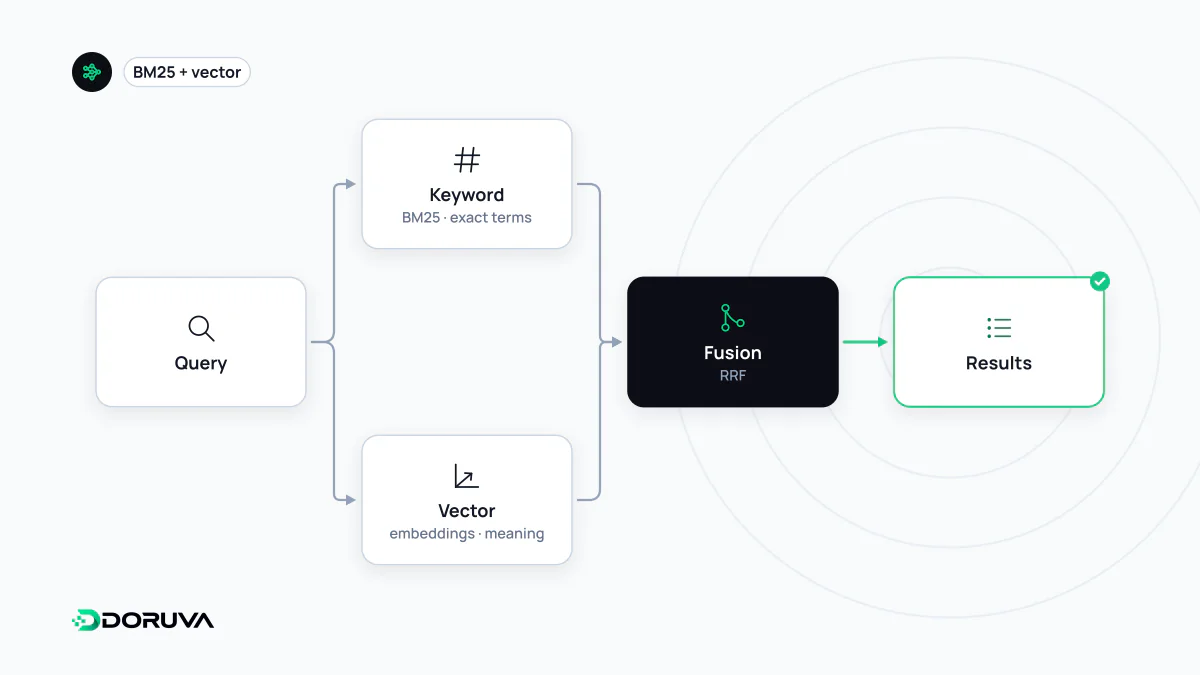
Hibrit arama (hybrid search), BM25 gibi kelime eşleşmesine dayalı sözcüksel arama ile embedding'lere dayalı vektör aramayı aynı sorguda çalıştırıp sonuçlarını tek bir sıralamada birleştiren yaklaşımdır. Sözcüksel arama ürün kodları ve tam ifadeler gibi birebir eşleşmeleri, vektör arama farklı kelimelerle ifade edilmiş aynı anlamı yakalar. Sonuçlar genellikle Reciprocal Rank Fusion (RRF) veya ağırlıklı puan birleştirme ile harmanlanır.
Diğer adları: hybrid search, hibrit getirme, hybrid retrieval, karma arama
İki yöntemin birbirini tamamladığı yer
Bir yardım merkezinde iki farklı arama düşünün. Birinde kullanıcı tarayıcının gösterdiği hata kodunu aynen yapıştırıyor: ERR_SSL_PROTOCOL_ERROR. Diğerinde derdini kendi cümleleriyle anlatıyor: “siteme girince güvenli bağlantı kurulamadı diyor”. İlk sorguda kazanan sözcüksel aramadır, çünkü kod bir anlam değil bir dizgedir ve birebir eşleşme gerekir. İkincisinde vektör arama öne geçer, çünkü kullanıcının kelimeleri belgedeki kelimelerle örtüşmez ama anlamı örtüşür.
Gerçek kullanıcılar her iki türü de sorar. Hibrit arama, iki yöntemi aynı sorguda paralel çalıştırıp sonuçları birleştirerek birinin zayıf kaldığı yerde diğerinin devreye girmesini sağlar.
Sözcüksel taraf: BM25
BM25, sözcüksel aramada en yaygın kullanılan puanlama fonksiyonudur. Üç fikre dayanır: bir terim belgede ne kadar sık geçerse puan artar ama bu artış giderek doyuma ulaşır; koleksiyonda nadir geçen terimler daha değerlidir; uzun belgeler sırf uzun oldukları için avantaj kazanmasın diye uzunluğa göre düzeltme yapılır. Hesaplama ters dizin üzerinde yapıldığı için çok hızlıdır.
Türkçede bu tarafın kalitesi büyük ölçüde dil çözümleyicisine bağlıdır. “Faturamı”, “faturanın” ve “faturalar” biçimlerini aynı köke indirgemeyen bir kurulum, ilgili belgeleri kaçırır. Vektör tarafı bu çekim farklarına karşı daha dayanıklıdır; hibrit yaklaşımın Türkçe projelerde sık tercih edilmesinin bir nedeni de budur.
Sonuçları birleştirmek: RRF ve ağırlıklı toplam
Temel güçlük, iki yöntemin puanlarının karşılaştırılamaz olmasıdır: BM25 puanının üst sınırı yoktur, kosinüs benzerliği ise dar bir aralıkta kalır. İki yaygın çözüm vardır.
Reciprocal Rank Fusion (RRF) puanları tamamen yok sayar ve yalnızca sıralara bakar. Her belge, yer aldığı her listede 1 / (k + sıra) kadar puan alır ve bunlar toplanır. Yöntem 2009'da Cormack, Clarke ve Büttcher tarafından önerilmiştir; Elasticsearch gibi sistemlerde k'nın varsayılan değeri 60'tır. Küçük bir örnek:
| Belge | BM25 sırası | Vektör sırası | RRF puanı (k = 60) |
|---|---|---|---|
| A | 1 | 3 | 1/61 + 1/63 ≈ 0,03227 |
| B | 2 | 1 | 1/62 + 1/61 ≈ 0,03252 |
| D | yok | 2 | 1/62 ≈ 0,01613 |
| E | 3 | yok | 1/63 ≈ 0,01587 |
Birleşik sıralama B, A, D, E olur. Her iki listede de üst sıralarda olan belge öne çıkar; tek listede görünen belgeler geride kalır ama elenmez. RRF'nin cazibesi ayar gerektirmemesidir.
Ağırlıklı birleştirme ise iki puanı önce aynı ölçeğe çeker (ör. min-max normalizasyonu), sonra α × sözcüksel + (1 − α) × vektör gibi bir formülle toplar. Daha fazla kontrol sağlar, ama α değerinin gerçek sorgularla ayarlanması gerekir ve normalizasyon her sorguda farklı davranabilir.
Birleştirmeden sonra
Hibrit arama bir getirme tekniğidir; amacı ilgili adayları kaçırmamaktır. Birleşik listenin ilk birkaç düzine sonucu genellikle daha pahalı bir modelle yeniden sıralanır ve son alaka puanlaması orada yapılır. Hangi kurulumun daha iyi olduğu ise tahminle değil, gerçek sorulardan oluşan bir test setinde recall ölçülerek anlaşılır.
Ne zaman gereksiz?
İki dizini birlikte işletmek ek maliyettir. Sorguların neredeyse tamamı ürün kodu veya kimlik aramasıysa sözcüksel arama tek başına yeterli olabilir. Kod ve özel ad içermeyen, tamamen doğal dilde sorulardan oluşan bir kullanımda ise vektör arama tek başına iyi sonuç verebilir. Hibrit yaklaşım, sorgu karışımının gerçekten karışık olduğu yerde değerini gösterir.