

Veritabanı İndeksi Nedir?
Kısa tanım
Veritabanı indeksi, bir tablodaki bir veya birkaç sütunun değerlerini sıralı ve hızlı aranabilir bir yapıda, genellikle B-tree içinde, satırlara işaret edecek biçimde tutan ek veri yapısıdır. Sorgu bütün tabloyu taramak yerine indeks üzerinden ilgili satırlara doğrudan ulaşır. Okumaları ciddi biçimde hızlandırır; karşılığında disk alanı kaplar ve her ekleme, güncelleme ve silmede güncellenmesi gerektiği için yazmaları yavaşlatır.
Diğer adları: database index, indeks, index, B-tree indeks, dizin
İndeks olmadan ne olur?
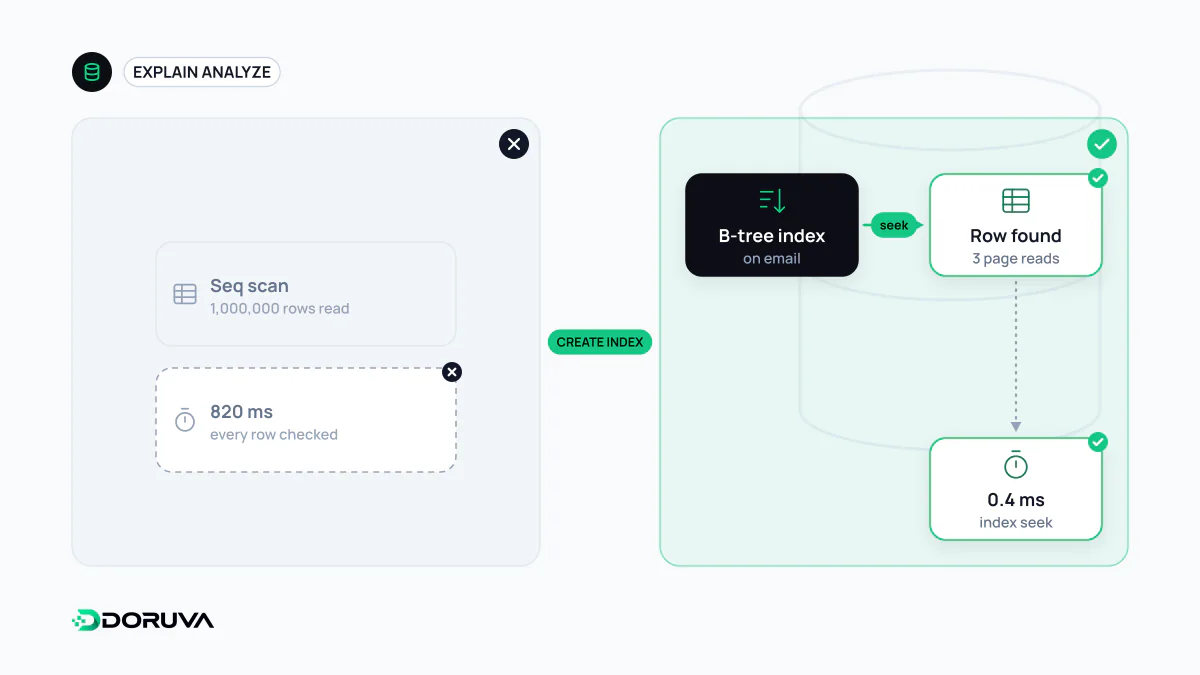
İndeksi olmayan bir tabloda WHERE email = '[email protected]' koşulunu karşılayan satırı bulmanın tek yolu, tablonun tamamını baştan sona okumaktır (sequential scan). Bin satırlık bir tabloda bu fark edilmez; yirmi milyon satırlık bir sipariş tablosunda ise her sayfa açılışında saniyeler harcanır ve aynı anda gelen birkaç istek veritabanını kilitlenmiş gibi gösterebilir. İndeks, bir kitabın sonundaki dizine benzer: aranan değeri sıralı bir listede bulur ve satırın nerede durduğunu doğrudan gösterir.
B-tree sezgisi
İlişkisel veritabanlarında varsayılan indeks türü B-tree'dir. Kökten yapraklara inen, her zaman dengeli tutulan bir ağaçtır ve her düğümü yüzlerce anahtar barındıran bir disk sayfasıdır. Bu geniş dallanma sayesinde yüz milyonlarca satırlık bir tabloda bile aranan değere birkaç sayfa okumasıyla ulaşılır. Yaprak düğümler sıralı ve birbirine bağlı olduğu için B-tree yalnızca eşitlik aramalarına değil, <, >, BETWEEN gibi aralık sorgularına, ORDER BY sıralamasına ve LIKE 'abc%' gibi başından sabit desenlere de hizmet eder. LIKE '%abc' gibi sonu sabit desenlerde ise işe yaramaz. PostgreSQL, JSONB ve tam metin arama için GIN, coğrafi veriler için GiST gibi başka indeks türleri de sunar.
Bileşik indekste sütun sırası belirleyicidir
Birden fazla sütun içeren bir indeks, önce ilk sütuna, eşitlik durumunda ikinciye göre sıralanır. Telefon rehberindeki “soyad, ad” sıralamasını düşünün: soyada göre arama hızlıdır, yalnızca ada göre arama değildir.
CREATE INDEX idx_orders_customer_created
  ON orders (customer_id, created_at DESC);
Bu indeks “bir müşterinin son siparişleri” sorgusunu hem filtreleme hem sıralama açısından tek başına karşılar; yalnızca customer_id ile yapılan sorgulara da yarar. Yalnızca created_at üzerinden yapılan bir aramaya ise yardımcı olmaz. Sütunu bir fonksiyonun içine almak da indeksi devre dışı bırakır: WHERE lower(email) = ... için ya ifade indeksi (expression index) oluşturulmalı ya da veri baştan normalize edilmiş biçimde saklanmalıdır.
EXPLAIN ile ne olduğunu görmek
Bir indeksin gerçekten kullanılıp kullanılmadığını tahmin etmek yerine sorgu planına bakılır. PostgreSQL'de EXPLAIN planı, EXPLAIN ANALYZE ise sorguyu gerçekten çalıştırıp ölçülen süreleri gösterir; MySQL'de de EXPLAIN benzer bilgi verir. Aşağıdaki çıktı kısaltılmış bir örnektir:
EXPLAIN ANALYZE
SELECT id, total FROM orders
WHERE customer_id = 4821
ORDER BY created_at DESC LIMIT 20;

-- İndeks yokken
Limit
  -> Sort
       -> Seq Scan on orders
            Filter: (customer_id = 4821)
            Rows Removed by Filter: 1999870

-- İndeks eklendikten sonra
Limit
  -> Index Scan using idx_orders_customer_created on orders
       Index Cond: (customer_id = 4821)
Seq Scan ve yüksek “Rows Removed by Filter” değeri, eksik bir indeksin tipik işaretidir. Planlayıcının indeksi kullanmaması her zaman hata değildir: sorgu tablonun büyük bir bölümünü döndürecekse tamamını okumak gerçekten daha ucuz olabilir. EXPLAIN ANALYZE sorguyu çalıştırdığı için UPDATE veya DELETE üzerinde kullanılırken bir işlem içinde çalıştırılıp geri alınmalıdır.
Her indeksin bir faturası var
- Yazma maliyeti: Her
INSERT,UPDATEveDELETEtablodaki ilgili tüm indeksleri de günceller. Yazma ağırlıklı bir tabloda gereksiz her indeks doğrudan yavaşlama demektir. - Alan ve bellek: İndeksler diskte yer kaplar ve verimli çalışmak için belleğe sığmak ister.
- Düşük seçicilik: Yalnızca iki değeri olan bir boolean sütun üzerindeki indeks nadiren işe yarar.
- Oluşturma sırasında kilit: PostgreSQL'de normal
CREATE INDEXtablo üzerindeki yazmaları bitene kadar bekletir; büyük tablolardaCREATE INDEX CONCURRENTLYtercih edilir ve bu komut bir işlem bloğu içinde çalışmaz. Bu ayrıntı, indeks ekleyen veritabanı migrasyonları planlanırken hesaba katılmalıdır.
Birincil anahtar ve UNIQUE kısıtları kendi indekslerini otomatik oluşturur. Yabancı anahtar sütunları ise PostgreSQL'de otomatik indekslenmez ve join ile silme işlemlerinin hızı için çoğu zaman elle indekslenmelidir. İndeks kararını vermenin en sağlam yolu, yavaş sorgu kayıtlarından gerçek SQL sorgularını toplayıp her birinin planını incelemektir.