

Tarama Bütçesi (Crawl Budget) Nedir?
Kısa tanım
Tarama bütçesi, Google'ın belirli bir zaman diliminde bir sitede taramak isteyip tarayabildiği URL'lerin toplamıdır. Sunucunun kaldırabileceği yükü gösteren tarama kapasitesi sınırı ile Google'ın sayfalara duyduğu ilgiyi ifade eden tarama talebinin birleşimiyle belirlenir. Google'a göre bu konu esas olarak çok büyük ya da içeriği çok hızlı değişen siteleri ilgilendirir; çoğu site için sorun değildir.
Diğer adları: crawl budget, tarama kotası, Googlebot tarama bütçesi
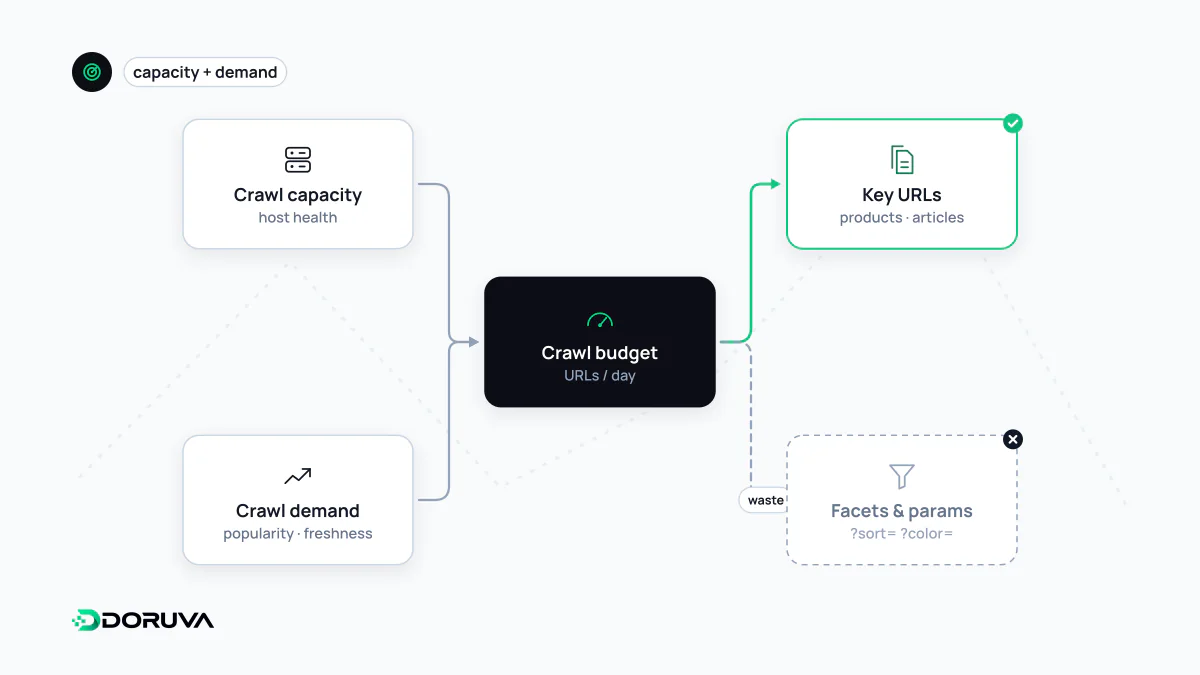
İki bileşen: kapasite ve talep
Googlebot'un zamanı ve kaynakları sınırsız değildir; aynı zamanda sitenizin sunucusunu zorlamaktan da kaçınır. Google'ın tanımına göre tarama bütçesi iki unsurun kesişimidir:
- Tarama kapasitesi sınırı: Googlebot'un sunucuyu yormadan aynı anda kaç bağlantı açabileceği ve istekler arasında ne kadar bekleyeceği. Sunucu hızlı ve sağlıklı yanıt verdikçe sınır yükselir; yavaşlama, 5xx hataları veya
429yanıtları geldikçe düşer. - Tarama talebi: Google'ın siteyi ne kadar taramak istediği. Bilinen URL sayısı, sayfaların popülerliği ve içeriğin ne sıklıkla güncellendiği bu talebi belirler. Site taşıma gibi büyük değişiklikler de talebi geçici olarak artırabilir.
Kapasite yüksek olsa bile talep düşükse Google siteyi daha az tarar. Yani tarama bütçesi yalnızca sunucu gücüyle büyütülebilecek bir şey değildir.
Kimlerin dert etmesi gerekir?
Google'ın büyük siteler için yayımladığı rehber, konunun hangi siteleri ilgilendirdiğini açıkça yazar:
| Site profili | Benzersiz sayfa sayısı | İçerik değişim sıklığı |
|---|---|---|
| Büyük siteler | 1 milyon ve üzeri | Orta (haftada bir civarı) |
| Orta ve büyük siteler | 10.000 ve üzeri | Çok hızlı (günlük) |
Rehber, boyutu ne olursa olsun URL'lerinin büyük bölümü Search Console'da “Keşfedildi - şu anda dizine eklenmedi” durumunda bekleyen siteleri de bu gruba dahil eder. Aynı rehber, sayfaları yayımlandığı gün taranan ve çok sayıda hızlı değişen sayfası olmayan sitelerin bu konuyla uğraşmasına gerek olmadığını belirtir. Kurumsal bir site, bir hizmet firması ya da birkaç yüz ürünlü bir mağaza için tarama bütçesi nadiren gerçek bir darboğazdır. Google ayrıca daha fazla taranmanın tek başına daha iyi sıralama anlamına gelmediğini vurgular.
Bütçeyi boşa harcayan durumlar
- Sonsuz URL alanları: Filtre kombinasyonları, sıralama parametreleri, oturum kimlikleri, ileri doğru sonsuza kadar giden takvim sayfaları.
- Kopya adresler: Aynı içeriğe giden çok sayıda URL; bunlar canonical ile birleştirilse bile taranmaya devam edebilir.
- Soft 404'ler: “Ürün bulunamadı” diyen ama
200döndüren sayfalar. Silinen sayfalar404veya410durum kodu döndürmelidir. - Uzun yönlendirme zincirleri: Google, uzun yönlendirme zincirlerinin taramayı olumsuz etkilediğini belirtir.
- Yavaş sunucu: Yanıt süresi uzadıkça kapasite sınırı düşer.
Ne yapılabilir?
Taranmasını hiç istemediğiniz URL desenlerini robots.txt ile engellemek, Google'ın önerdiği temel yöntemdir:
User-agent: *
Disallow: /*?siralama=
Disallow: /sepet/
Bu amaçla noindex kullanmak işe yaramaz: Google sayfayı yine ister, ancak noindex'i gördükten sonra dizinden çıkarır; tarama isteği harcanmış olur. Önemli sayfaların güncel kalmasını istiyorsanız XML site haritasını güncel tutun ve değişen sayfalar için <lastmod> değerini doğru verin. Sunucu geçici olarak aşırı yüklendiğinde 503 veya 429 döndürmek taramayı yavaşlatır, ama bu uzun süreli bir çözüm olarak kullanılmamalıdır.
Nasıl izlenir?
Search Console'daki Tarama İstatistikleri raporu, günlük istek sayısını, ortalama yanıt süresini ve yanıtların durum kodlarına göre dağılımını gösterir. Daha ayrıntılı tablo için sunucu erişim günlüklerinde Googlebot isteklerini incelemek gerekir. Tüm ayrıntılar Google'ın tarama bütçesi yönetimi rehberinde yer alır; temel kavramlar için tarama maddesine de bakabilirsiniz.