

Noindex Nedir?
Kısa tanım
Noindex, bir sayfanın veya dosyanın arama motoru dizinine eklenmemesini isteyen bir robots kuralıdır. Sayfanın head bölümüne eklenen robots meta etiketiyle ya da sunucunun gönderdiği X-Robots-Tag HTTP başlığıyla uygulanır. Google bu kurala uyar, ancak kuralı görebilmesi için sayfayı tarayabilmesi gerekir; bu yüzden noindex verilen bir sayfa robots.txt ile engellenmemelidir.
Diğer adları: meta robots noindex, X-Robots-Tag noindex, noindex etiketi
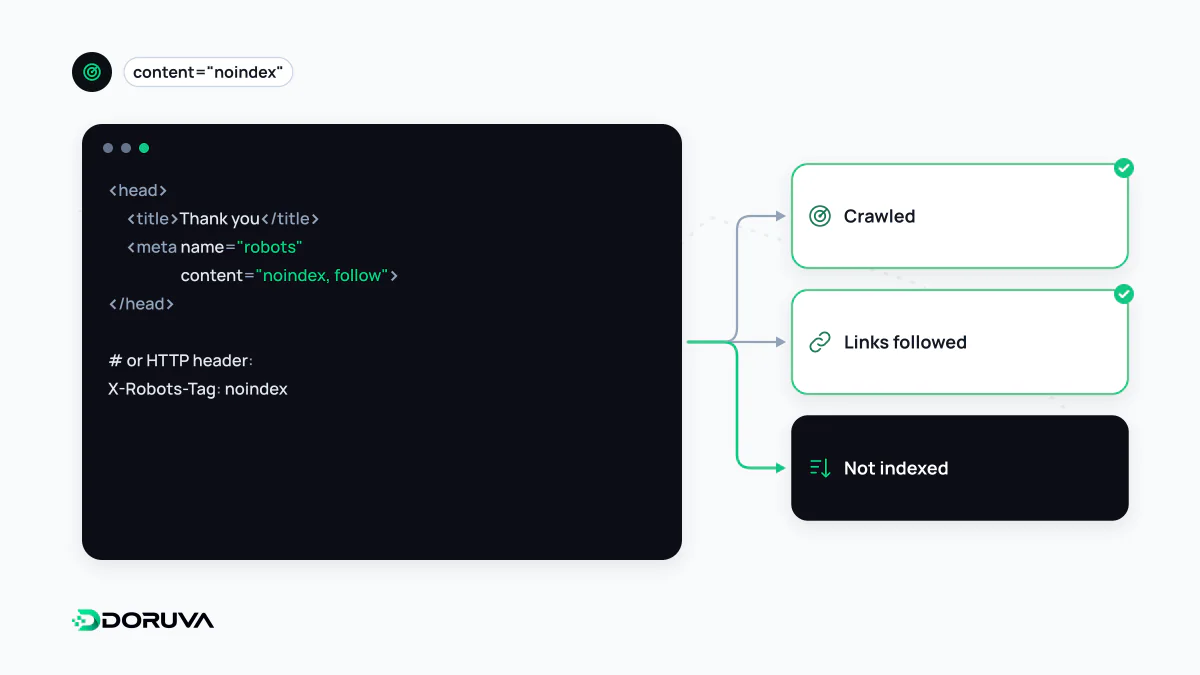
İki uygulama yolu
HTML sayfalarında noindex, <head> içine eklenen bir meta etiketle verilir:
<meta name="robots" content="noindex">Kuralı yalnızca Google'ın tarayıcısına yöneltmek isterseniz name="googlebot" kullanabilirsiniz. PDF, görsel gibi HTML olmayan dosyalarda meta etiket eklenemeyeceği için aynı kural HTTP yanıt başlığıyla gönderilir:
HTTP/1.1 200 OK
X-Robots-Tag: noindex
Robots.txt ile karıştırmayın
Noindex ile robots.txt farklı soruları yanıtlar. Robots.txt “bu adresi tarama” der; noindex ise “bu sayfayı tara ama dizine ekleme”. İkisi birlikte yanlış kullanıldığında sonuç beklenenin tersi olur: robots.txt ile engellenen bir sayfa taranmadığı için Google noindex kuralını hiç göremez. Bu sayfa başka sitelerden bağlantı alıyorsa, içeriği okunmamış olsa bile adresi sonuçlarda görünmeye devam edebilir.
Ayrıca robots.txt dosyasına yazılan Noindex: satırı Google tarafından desteklenmez; Google bu resmi olmayan kuralı 2019'da tamamen bıraktı.
| Amaç | Uygun araç |
|---|---|
| Sayfa erişilebilir kalsın ama arama sonuçlarında çıkmasın | noindex |
| Botlar belirli adresleri hiç taramasın | robots.txt |
| Kopya sürümler asıl adrese bağlansın | canonical URL veya yönlendirme |
| İçerik kimse tarafından görülmesin | Parola veya oturum ile koruma |
Tipik kullanım alanları
- Site içi arama sonuç sayfaları
- Form gönderiminden sonraki teşekkür sayfaları
- Kullanıcı hesabı, sepet ve ödeme adımları
- İçeriği çok zayıf olan otomatik etiket veya arşiv sayfaları
- Kampanya bittikten sonra erişilebilir kalması gereken ama aranması anlamsız sayfalar
Sık yapılan hatalar
- Test ortamından kalan noindex: Geliştirme sırasında tüm siteye eklenen noindex, canlıya çıkışta kaldırılmazsa site kısa sürede arama sonuçlarından düşmeye başlar. Yayın kontrol listesinin ilk maddelerinden biri olmalıdır.
- Site haritasında noindex'li sayfa: XML site haritası “bu sayfayı dizine ekle” anlamına gelir; noindex ile çelişir ve Search Console'da hata olarak raporlanır.
- Canonical yerine noindex kullanmak: Kopya sayfaları noindex ile gizlemek, sinyalleri asıl sayfada toplamaz. Google, canonical belirlemek için noindex kullanılmasını önermez.
- Noindex'i JavaScript ile kaldırmaya çalışmak: Google, ilk HTML'de noindex gördüğünde sayfayı render etmeyebilir. Etiketi istemci tarafında silmek bu yüzden işe yaramaz; konu JavaScript SEO açısından önemlidir.
- Noindex'i nofollow ile karıştırmak: Nofollow bağlantılarla ilgilidir; sayfanın dizinde kalıp kalmamasını belirlemez.
Etki ne zaman görülür?
Noindex, Google sayfayı yeniden taradığında devreye girer. Sayfa birkaç gün ya da hafta içinde dizinden düşer; Search Console'daki URL Denetleme aracından yeniden tarama istemek süreci hızlandırabilir. Acil durumlarda Kaldırma aracı bir URL'yi sonuçlardan geçici olarak gizler, ama kalıcı çözüm yine noindex, 404/410 ya da erişimi kısıtlamaktır. Kuralların tamamı Google'ın noindex belgesinde açıklanır.