

Tarama (Crawling) Nedir?
Kısa tanım
Tarama (crawling), arama motorlarının ve diğer otomatik sistemlerin tarayıcı (crawler, bot veya örümcek) adı verilen programlarla web'deki sayfaları bulup içeriklerini indirmesi sürecidir. Google'ın tarayıcısı Googlebot, bilinen sayfalardaki bağlantıları ve site haritalarını izleyerek yeni URL'ler keşfeder; taranan sayfalar daha sonra dizine eklenmek üzere işlenir.
Diğer adları: crawling, web tarama, crawler, tarayıcı bot
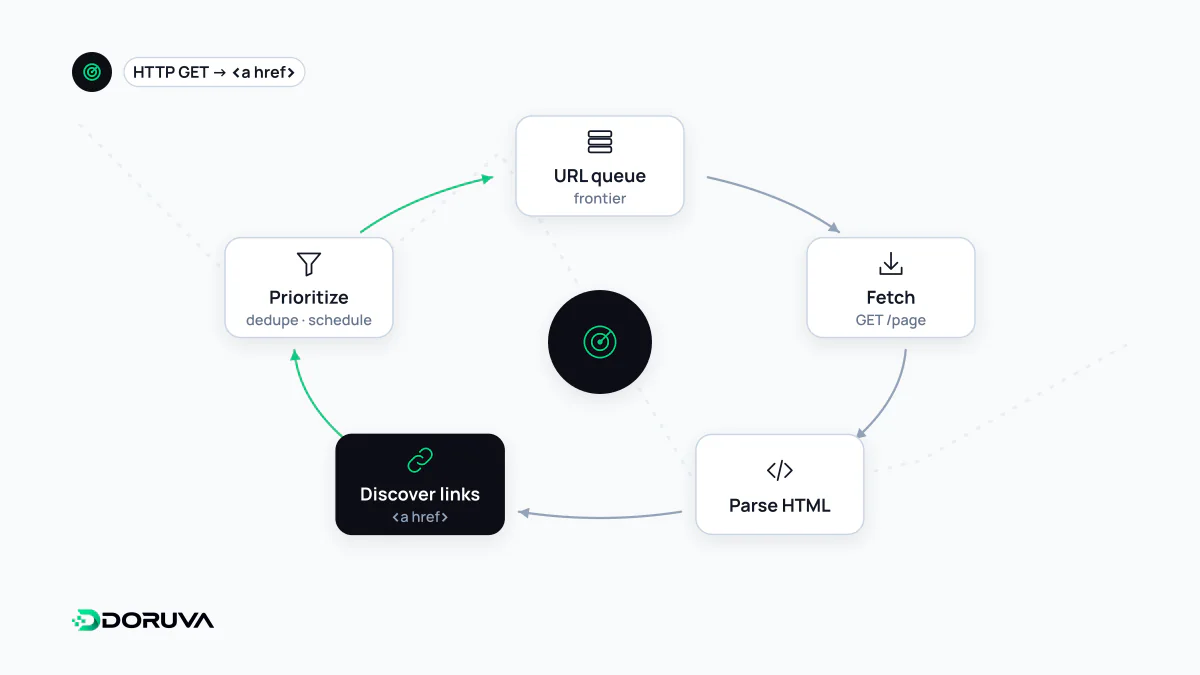
Tarayıcı (bot) dediğimiz program
Tarayıcı, web sayfalarını otomatik olarak isteyen ve indiren bir yazılımdır; "bot" ya da "örümcek" (spider) olarak da anılır. Her tarayıcı, isteklerinde kendini tanıtan bir user-agent değeri gönderir. Google'ın ana tarayıcısı Googlebot'tur ve iki türü vardır: mobil bir kullanıcıyı taklit eden Googlebot Smartphone ve masaüstü kullanıcıyı taklit eden Googlebot Desktop. Google çoğunlukla sayfaların mobil sürümünü dizine eklediği için isteklerin büyük kısmı mobil tarayıcıdan gelir.
Web'de yalnızca arama motoru botları dolaşmaz; Bingbot gibi diğer arama motorlarının tarayıcıları, SEO araçlarının botları ve son yıllarda sayısı hızla artan yapay zekâ tarayıcıları da siteleri düzenli olarak ziyaret eder.
Tarama adım adım
- URL keşfi: Google yeni adresleri daha önce bildiği sayfalardaki bağlantılardan ve gönderilen XML site haritalarından öğrenir.
- Planlama: Hangi URL'nin ne zaman ve ne sıklıkla taranacağına algoritmik olarak karar verilir. Sunucunun kaldırabileceği yük de bu kararın parçasıdır.
- İzin kontrolü: Tarayıcı, sitenin robots.txt dosyasını okuyup URL'yi isteyip isteyemeyeceğine bakar.
- İndirme: Sayfa istenir; sunucunun döndürdüğü HTTP durum kodu sürecin nasıl devam edeceğini belirler (200 içerik, 301 yeni adres, 404 sayfa yok gibi).
- Rendering: Google sayfayı güncel bir Chrome sürümüyle işler ve JavaScript'i çalıştırır. JavaScript'e dayanan sitelerde bu adımın ayrıntıları JavaScript SEO maddesinde anlatılıyor.
- Yeni bağlantılar: Sayfada bulunan bağlantılar kuyruğa eklenir ve döngü devam eder.
Taranmış olmak dizine eklenmiş olmak demek değildir. Tarama yalnızca içeriği getirir; sayfanın dizine alınıp alınmayacağına dizine ekleme aşamasında karar verilir.
Taramayı zorlaştıran durumlar
- Sunucu sorunları: Google, sunucu sık sık 5xx hatası ya da 429 (çok fazla istek) döndürdüğünde tarama hızını düşürür.
- Takip edilemeyen bağlantılar:
hrefdeğeri olmayan, yalnızca JavaScript tıklama olayıyla çalışan bağlantılar tarayıcı için bağlantı değildir. - Sonsuz URL alanları: Filtre kombinasyonları, takvim sayfaları ve oturum parametreleri neredeyse sınırsız URL üretebilir. Büyük sitelerde bu durum tarama bütçesinin boşa harcanmasına yol açar.
- Yanlış engellemeler: Robots.txt ile sayfayı işlemek için gereken CSS ve JavaScript dosyalarının engellenmesi.
Gerçek Googlebot nasıl doğrulanır?
User-agent değeri kolayca taklit edilebildiği için, log'larda "Googlebot" yazan her istek Google'dan gelmez. Google iki yöntem önerir: isteğin IP adresini Google'ın yayımladığı IP aralığı listeleriyle karşılaştırmak ya da ters ve ileri DNS sorgusu yapmak:
# 1) IP adresinden alan adına (ters DNS)
host 66.249.66.1
# Sonuç googlebot.com, google.com veya googleusercontent.com ile bitmeli

# 2) Bulunan alan adından tekrar IP'ye (ileri DNS)
host crawl-66-249-66-1.googlebot.com
# Dönen IP, ilk sorgudaki IP ile aynı olmalı
Ayrıntılı adımlar Google'ın Googlebot'u doğrulama belgesinde yer alır.
Taramayı izlemek
Search Console'daki Tarama istatistikleri raporu, Google'ın siteye günde kaç istek gönderdiğini, ortalama yanıt süresini ve dönen durum kodlarının dağılımını gösterir. Sunucu log'ları ise hangi botun hangi URL'ye ne zaman geldiğini en ayrıntılı biçimde ortaya koyar.