

Programatik SEO Nedir?
Kısa tanım
Programatik SEO, yapılandırılmış bir veri kümesini bir sayfa şablonuyla birleştirerek çok sayıda benzer arama sorgusunu karşılayan sayfaları otomatik olarak üretme yöntemidir. Döviz çevirici, entegrasyon ya da şehir bazlı ilan sayfaları tipik örneklerdir. Her sayfa gerçekten farklı ve yararlı veri sunmuyorsa yöntem, Google'ın ölçekli içerik kötüye kullanımı ve doorway politikalarıyla çatışır.
Diğer adları: programmatic SEO, pSEO, ölçekli sayfa üretimi, şablon tabanlı SEO
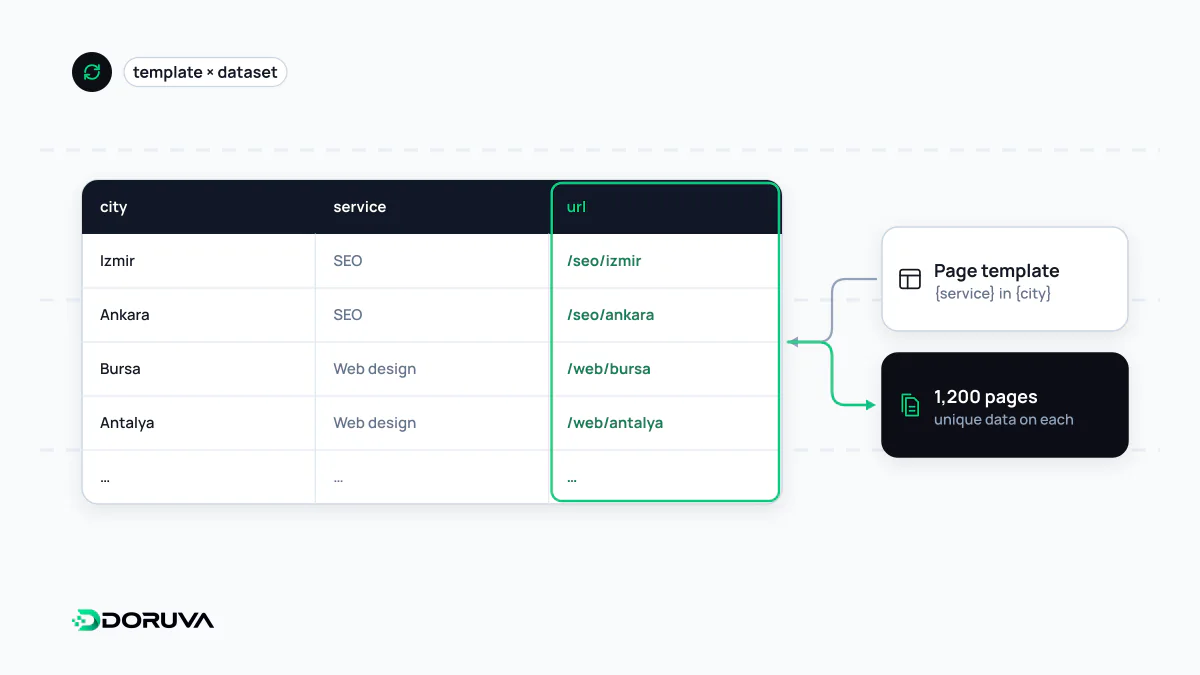
Veri, şablon ve URL kalıbı
Programatik SEO'nun dört yapı taşı vardır: satırları sayfalara dönüşecek bir veri kümesi, bu veriyi okunabilir bir sayfaya çeviren şablon, öngörülebilir bir URL kalıbı ve binlerce sayfayı birbirine bağlayan üst sayfalar (hub). Sorgu tarafında ise aynı kalıba uyan çok sayıda uzun kuyruklu arama hedeflenir.
- "100 dolar kaç TL", "50 euro kaç sterlin" gibi döviz çevirme sayfaları,
- bir SaaS ürününün "X ile Y entegrasyonu" sayfaları,
- ilan ve emlak sitelerinin "Kadıköy kiralık daire" gibi konum ve kategori kesişimleri,
- ürün ya da yazılım karşılaştırma sayfaları.
Yöntemin kendisi ne iyi ne kötüdür. Büyük e-ticaret ve ilan sitelerinin kategori sayfaları da aslında programatik olarak üretilir. Belirleyici olan, her sayfanın arayan kişiye o sorgu için gerçekten bir şey söyleyip söylemediğidir.
İyi bir programatik sayfayı ne ayırır?
Basit bir test işe yarar: şablondaki değişkeni değiştirdiğinizde sayfanın geri kalanında da anlamlı bir şey değişiyor mu? İstanbul ve İzmir sayfalarında yalnızca şehir adı farklıysa ortada bir veri sayfası değil, kopyalanmış bir metin vardır. İyi örneklerde her satır kendi verisini taşır: güncel kur, gerçek ilan sayısı ve fiyat aralığı, entegrasyonun hangi alanları eşlediği, o ilçeye özgü bilgiler.
Yayın kararını da veriye bağlamak gerekir. Aşağıdaki gibi bir eşik, içi boş kombinasyonların hiç yayınlanmamasını sağlar:
for (const satir of veri) {
  // yeterli veri yoksa sayfa üretilmez
  if (satir.ilanSayisi < 5 || !satir.ortalamaFiyat) continue;

  sayfalar.push({
    url: "/kiralik/" + satir.ilce + "/",
    baslik: satir.ilceAdi + " Kiralık Daire İlanları",
    ozet: satir.ilanSayisi + " ilan, ortalama " + satir.ortalamaFiyat + " TL",
  });
}
Google'ın politikaları: ölçekli içerik ve doorway
Google'ın spam politikaları, ölçekli içerik kötüye kullanımını (scaled content abuse) çok sayıda sayfanın kullanıcıya yardım etmek için değil, öncelikle arama sıralamasını manipüle etmek için üretilmesi olarak tanımlar ve bunun içeriğin nasıl üretildiğinden bağımsız olduğunu vurgular. Verilen örnekler arasında şunlar var:
- üretken yapay zekâ araçlarıyla değer katmadan çok sayıda sayfa üretmek,
- feed'leri, arama sonuçlarını ya da başka içerikleri kazıyıp eş anlamlı kelime değiştirme veya çeviri gibi otomatik dönüşümlerle sayfa çoğaltmak,
- farklı sayfalardan içerik parçalarını değer katmadan birleştirmek.
Aynı politikalardaki doorway kötüye kullanımı da programatik projeler için doğrudan önemlidir: belirli bölgeler ya da şehirler için oluşturulup kullanıcıyı tek bir sayfaya yönlendiren sayfalar ve gezinilebilir bir hiyerarşiden çok arama sonuçlarına benzeyen, birbirine çok yakın sayfalar örnek olarak sayılır. Metni yapay zekâyla "zenginleştirmek" bu sorunu çözmez; eksik olan şey kelime değil, veridir. Sonuç çoğu zaman zayıf içerik olarak değerlendirilen binlerce sayfadır.
Teknik riskler: dizin şişmesi ve tarama
On binlerce URL'yi bir gecede yayına almak, arama motorunun bu sayfaları aynı hızla tarayıp dizine ekleyeceği anlamına gelmez. Büyük sitelerde tarama bütçesi sınırlıdır; düşük değerli sayfalar değerli olanların taranmasını geciktirebilir. Search Console'un Sayfa dizine ekleme raporunda "Crawled – currently not indexed" (taranmış, şu anda dizine eklenmemiş) durumunda biriken binlerce URL, Google'ın bu sayfalarda yeterli değer görmediğinin tipik bir işaretidir.
Sık görülen bir başka sorun da bağlantısız sayfalardır: yalnızca site haritasında bulunan ama hiçbir kategori ya da hub sayfasından bağlantı almayan URL'ler yetim sayfa olarak kalır.
Yayına almadan önce kontrol listesi
- Her sayfa, başka hiçbir sayfada olmayan ve sorguya cevap veren veri taşıyor mu?
- Veri kaynağı güvenilir ve güncel tutulabiliyor mu? Eskiyen kurlar ya da kapanmış ilanlar sayfayı yanıltıcı hâle getirir.
- Yetersiz veri olan kombinasyonlar için yayınlamama ya da
noindexkuralı var mı? - Sayfalar mantıklı bir hiyerarşiyle iç bağlantı alıyor mu?
- Önce küçük bir örneklemle başlanıp dizine eklenme oranı ve gerçek tıklamalar izlendi mi?