

NoSQL Nedir?
Kısa tanım
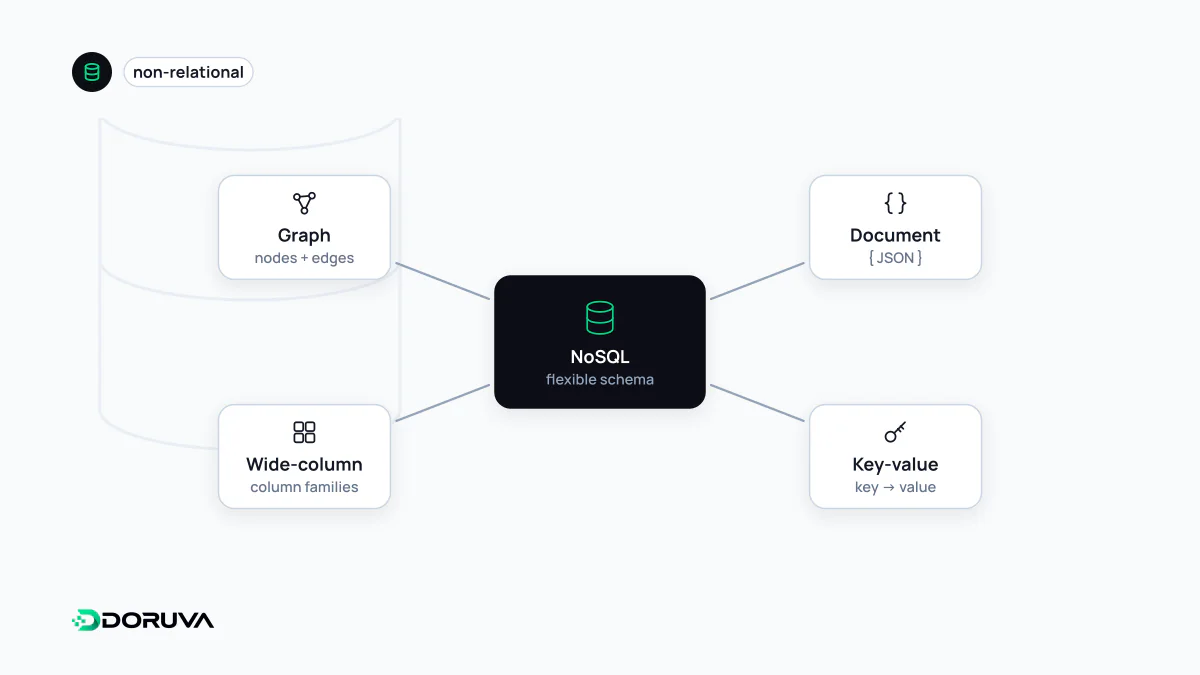
NoSQL, veriyi ilişkisel tablo modeli yerine doküman, anahtar-değer, geniş sütun veya graf gibi farklı modellerle saklayan veritabanlarının ortak adıdır. Bu sistemlerde tasarım genellikle uygulamanın hangi sorguları çalıştıracağından yola çıkar; veri çoğu zaman birden fazla sunucuya dağıtılır. Bunun karşılığında birleştirme (join) desteği, şema denetimi veya anlık tutarlılık gibi konularda ilişkisel sistemlerden farklı ödünleşimler kabul edilir.
Diğer adları: Not only SQL, ilişkisel olmayan veritabanı, non-relational database, doküman veritabanı
İsim neyi anlatıyor, neyi anlatmıyor?
NoSQL, bir teknolojiyi değil bir dışlamayı tarif eder: “ilişkisel tablo modeli değil”. Terim 2000'lerin sonunda, büyük web şirketlerinin tek sunucuya sığmayan veri hacimleri için geliştirdiği sistemlerle yaygınlaştı ve bugün çoğunlukla “Not only SQL” diye okunur. Bu şemsiyenin altındaki sistemler birbirinden, ilişkisel veritabanlarından olduğundan daha fazla farklıdır. Bir doküman veritabanı ile bir graf veritabanının ortak noktası neredeyse yalnızca tablo kullanmamalarıdır. Üstelik bazı NoSQL ürünleri SQL'e çok benzeyen sorgu dilleri sunar; yani “NoSQL = SQL yok” denklemi de tam doğru değildir.
Dört model, dört farklı tasarım sorusu
| Model | Veri birimi | Nasıl sorgulanır? | Tasarımın zor tarafı |
|---|---|---|---|
| Doküman | Kendi içinde bütün bir kayıt (ör. satırlarıyla birlikte bir sipariş) | Alanlara göre filtre, ikincil indeksler | Veriyi gömmek mi, ayrı dokümana referans vermek mi? |
| Anahtar-değer | Anahtar → değer | Yalnızca anahtarla | Değerin içinde arama yapılamaz; anahtar tasarımı her şeydir |
| Geniş sütun | Bir bölüm anahtarı (partition key) altında sıralı satırlar | Bölüm anahtarı vererek | Sorgular önceden bilinmeli; aynı veri farklı sorgular için birden fazla tabloya yazılır |
| Graf | Düğümler ve aralarındaki kenarlar | İlişkiler üzerinde gezinerek (traversal) | Çok büyük grafları sunuculara bölmek zordur |
Anahtar-değer modelinin en bilinen örneği olan Redis, değer olarak düz metin yerine liste, küme ve sıralı küme gibi veri yapıları tutabildiği için bu tablonun sınırlarını biraz esnetir. Embedding'leri saklayıp benzerlik araması yapan vektör veritabanları da çoğu zaman aynı aileye dahil edilir.
Önce sorgular, sonra veri modeli
İlişkisel tasarımda veri önce normalize edilir, yani her bilgi tek bir yerde tutulur; sorgular sonradan join'lerle kurulur. NoSQL tasarımında sıra çoğu zaman tersine döner: önce uygulamanın hangi ekranda hangi veriyi hangi anahtarla okuyacağı listelenir, veri bu okumalara göre şekillendirilir. Bir e-ticaret siparişi doküman modelinde şöyle saklanabilir:
{
  "_id": "ord_8412",
  "customer": { "id": "cus_77", "name": "Ayşe Yılmaz" },
  "shippingAddress": { "city": "İzmir", "district": "Bornova" },
  "lines": [
    { "sku": "TSH-BLK-M", "title": "Siyah tişört", "qty": 2, "unitPrice": 349.90 }
  ],
  "status": "shipped"
}
Sipariş ekranı tek bir okumayla dolar ve adres ile ürün adı sipariş anındaki hâliyle donmuş olur; bu, fatura gibi belgeler için zaten istenen bir davranıştır. Bedeli ise tekrardır: müşterinin adı değişirse ve bunun eski siparişlere de yansıması gerekiyorsa, güncelleme yüzlerce dokümana dağılır. Bu bilinçli tekrara denormalizasyon denir ve NoSQL tasarımının merkezinde durur.
Tutarlılık: neyi ne zaman göreceksiniz?
NoSQL sistemlerinin büyük kısmı veriyi birden fazla sunucuya kopyalar. Ağ bölündüğünde sistem ya bazı istekleri reddederek tutarlılığı korur ya da her isteğe yanıt verip kopyaların bir süre farklı kalmasına izin verir. CAP teoremi olarak bilinen bu ödünleşim, pratikte nihai tutarlılık (eventual consistency) kavramıyla karşınıza çıkar: kullanıcı profilini günceller, sayfayı yeniler ve henüz güncellenmemiş bir kopyadan eski adını görür.
Birçok sistem bu dengeyi istek bazında ayarlamaya izin verir. Üç kopyalı bir kümede yazmanın iki kopyada (W=2), okumanın da iki kopyada (R=2) onaylanması istenirse, R+W kopya sayısını aştığı için her okuma en az bir güncel kopyaya denk gelir. Daha düşük değerler gecikmeyi azaltır ama eski veri görme ihtimalini artırır. Tek doküman üzerindeki işlemler çoğu doküman veritabanında atomiktir; birden fazla dokümanı kapsayan işlem desteği ise ürüne ve yapılandırmaya göre değişir ve genellikle ek maliyet getirir.
Ne zaman uygun, ne zaman zorlama?
- Uygun: Erişim desenleri net ve sabit, yazma hacmi tek sunucunun kaldıramayacağı kadar yüksek, kayıtlar doğal olarak kendi içinde bütün (olay kayıtları, ürün katalogları, oturumlar) ya da ilişkiler üzerinde derin gezinme gerekiyor.
- Zorlama: Önceden bilinmeyen raporlar, çok sayıda varlık arasında tutarlı kalması gereken kurallar (stok, bakiye, fatura) ve sık değişen sorgu ihtiyaçları. Bu durumda join ve kısıtların eksikliği uygulama koduna taşınır.
Seçim çoğu zaman ya hep ya hiç değildir. Asıl iş verisi ilişkisel bir veritabanında, önbellek ve kuyruklar anahtar-değer deposunda durabilir. Esnek alanlar için ayrı bir sistem kurmak yerine PostgreSQL'in JSONB sütunları gibi ara çözümler de değerlendirilmelidir. Yatay ölçeklenebilirlik gerçek bir ihtiyaç değilse, NoSQL'in getirdiği tasarım yükü çoğu zaman karşılığını vermez.