

İlişkisel Veritabanı Nedir?
Kısa tanım
İlişkisel veritabanı, verileri satır ve sütunlardan oluşan tablolarda saklayan ve tablolar arasındaki bağlantıları anahtarlar aracılığıyla kuran veritabanı türüdür. Edgar F. Codd'un 1970'te tanımladığı ilişkisel modele dayanır; veriler SQL ile sorgulanır, kısıtlar ve işlemler (transaction) sayesinde tutarlı tutulur. PostgreSQL, MySQL, Microsoft SQL Server ve SQLite bu türün yaygın örnekleridir.
Diğer adları: Relational Database, RDBMS, İlişkisel veritabanı yönetim sistemi, SQL veritabanı, İlişkisel model
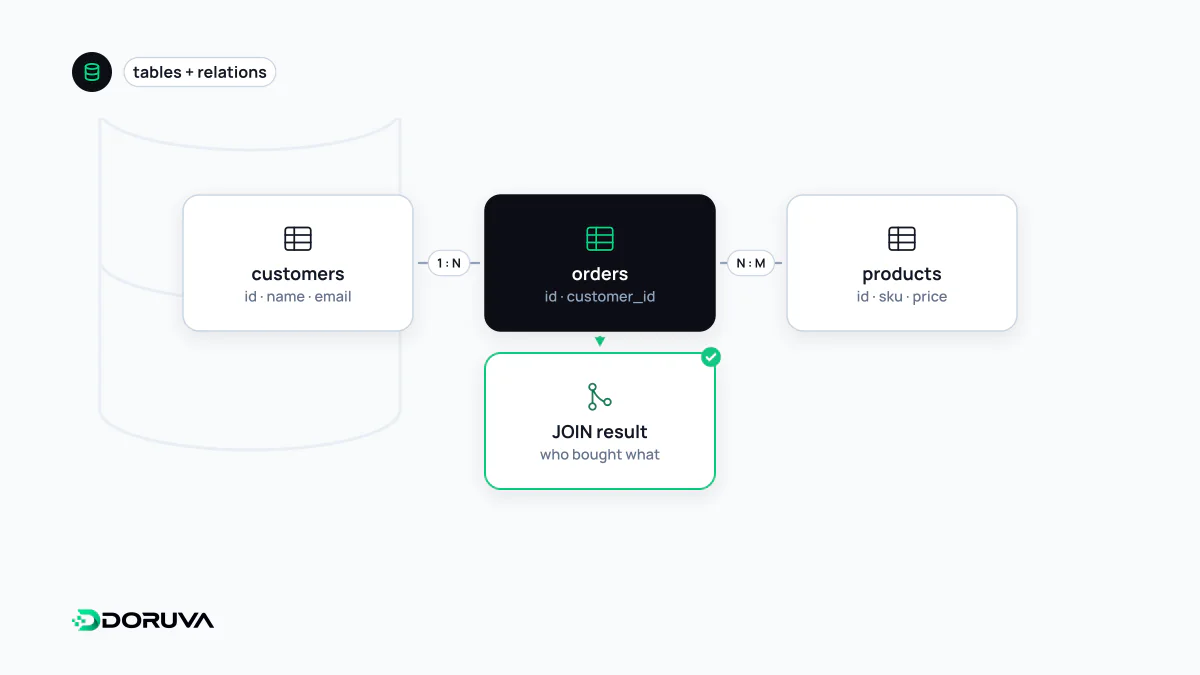
Tablolar, satırlar ve anahtarlar
İlişkisel modelde her tablo tek bir varlık türünü anlatır: müşteriler bir tabloda, siparişler başka bir tabloda durur. Her satırı benzersiz biçimde tanımlayan sütun birincil anahtardır. Bir tablodaki sütunun başka bir tablonun birincil anahtarına işaret etmesi ise ilişkiyi kurar; bu sütuna yabancı anahtar denir.
CREATE TABLE musteriler (
  id      INTEGER PRIMARY KEY,
  ad      TEXT NOT NULL,
  eposta  TEXT NOT NULL UNIQUE,
  sehir   TEXT
);

CREATE TABLE siparisler (
  id           INTEGER PRIMARY KEY,
  musteri_id   INTEGER NOT NULL REFERENCES musteriler(id),
  tarih        TEXT NOT NULL,
  tutar        NUMERIC NOT NULL CHECK (tutar >= 0)
);
Bu tanımdaki kısıtlar, veritabanının hatalı veriyi daha kayıt anında reddetmesini sağlar: aynı e-postayla ikinci müşteri açılamaz, var olmayan bir müşteriye sipariş yazılamaz, eksi tutar girilemez. Kuralların uygulama kodunda değil veritabanında durması, farklı servisler ve betikler aynı veriye yazdığında bile tutarlılığı korur.
Normalizasyon: her bilgi tek bir yerde
Müşterinin adını ve şehrini her sipariş satırına kopyalamak ilk bakışta pratik görünür. Ama müşteri taşındığında yüzlerce satırı güncellemek gerekir; biri atlanırsa aynı müşteri için iki farklı şehir kayıtlı kalır. Normalizasyon, veriyi tekrarı ortadan kaldıracak şekilde tablolara bölme sürecidir. Birinci normal form her hücrede tek bir değer ister; ikinci ve üçüncü normal formlar, her sütunun yalnızca kendi tablosunun anahtarına bağlı olmasını, başka bir sütun üzerinden dolaylı bağımlılık taşımamasını şart koşar.
Normalizasyon bir hedef değil, varsayılan başlangıç noktasıdır. Okuma hızının kritik olduğu raporlama tablolarında veriyi bilinçli olarak tekrar etmek (denormalizasyon) makul bir tercih olabilir; önemli olan bunun bir kaza değil, gerekçeli bir karar olmasıdır.
JOIN ile dağınık veriyi birleştirmek
Bölünmüş veri sorgu anında birleştirilir:
SELECT m.ad, COUNT(s.id) AS siparis_sayisi, COALESCE(SUM(s.tutar), 0) AS toplam
FROM musteriler m
LEFT JOIN siparisler s ON s.musteri_id = m.id
WHERE m.sehir = 'İzmir'
GROUP BY m.id, m.ad
ORDER BY toplam DESC;
INNER JOIN yalnızca iki tabloda da eşleşmesi olan satırları getirir; burada kullanılan LEFT JOIN ise hiç siparişi olmayan müşterileri de sıfır değerle listeler. Büyük tablolarda bu sorguların hızlı çalışması, birleştirme ve filtreleme sütunlarında uygun bir indeks bulunmasına bağlıdır. Sorgu dilinin kendisi SQL maddesinde ele alınıyor.
SQLite: sunucusuz bir ilişkisel veritabanı
İlişkisel veritabanı denince çoğu kişinin aklına ayrı bir sunucuda çalışan PostgreSQL veya MySQL gelir. SQLite ise farklı bir yol izler: ayrı bir sunucu süreci yoktur, uygulamanın içine gömülen bir kütüphanedir ve bütün veritabanı tek bir dosyada durur. SQLite'ın kendi sitesindeki tahmine göre her akıllı telefonda yüzlerce SQLite veritabanı bulunur ve kullanımdaki SQLite veritabanlarının sayısı bir trilyonu aşıyor olabilir; tarayıcılar, mobil uygulamalar ve masaüstü yazılımları veriyi çoğunlukla bu şekilde saklar.
SQLite; mobil ve masaüstü uygulamaları, testler, prototipler ve okuma ağırlıklı küçük ve orta ölçekli web siteleri için güçlü bir seçimdir. Sınırı eşzamanlı yazmadır: aynı anda yalnızca bir yazma işlemi yürür. WAL kipi okuyucuların yazma sırasında beklemesini önler, ama çok sayıda istemcinin sürekli yazdığı ya da birden fazla sunucunun aynı veritabanını paylaştığı sistemlerde istemci-sunucu mimarisindeki bir veritabanı daha uygundur.
İlişkisel mi, NoSQL mi?
İlişkisel veritabanlarının güçlü yanı, şema ile zorlanan yapı ve birden çok değişikliği tek bir bütün olarak uygulayan veritabanı işlemleridir. Bir para transferinde borç ve alacak kayıtlarının ya ikisi birden yazılır ya da hiçbiri yazılmaz. NoSQL sistemleri ise belge, anahtar-değer veya geniş sütun gibi farklı modellerle esnek yapılara ve yatay ölçeklemeye odaklanır. Sınır eskisi kadar keskin değildir: PostgreSQL JSON belgelerini indeksleyip sorgulayabilir, birçok NoSQL ürünü de işlem desteği ekledi. Çoğu iş uygulamasında doğru başlangıç noktası hâlâ iyi tasarlanmış bir ilişkisel şemadır.