

AI Görünürlüğü Nedir?
Kısa tanım
AI görünürlüğü, bir markanın ChatGPT search, Google AI Overviews ve AI Mode, Perplexity veya Claude gibi yapay zekâ destekli cevap sistemlerinde ne sıklıkla anıldığını, ne kadar doğru tanımlandığını ve kaynak olarak gösterilip gösterilmediğini ifade eder. Bu cevaplar her seferinde değişebildiği için görünürlük tek bir sıralamayla değil, tekrarlanan örnek sorularla ölçülür.
Diğer adları: yapay zekâ görünürlüğü, AI search visibility, LLM görünürlüğü, AI marka görünürlüğü
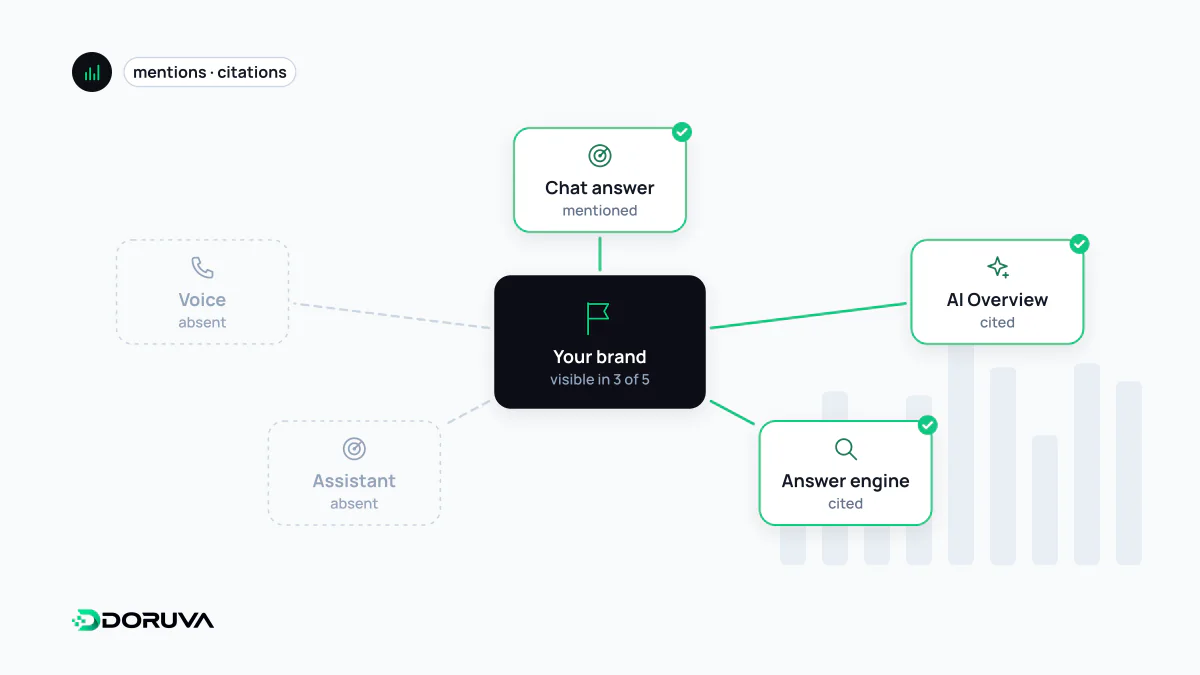
Üç boyutlu bir kavram
Klasik aramada görünürlük çoğu zaman “hangi sıradayım?” sorusuna indirgenir. Yapay zekâ cevaplarında ise ortada tek bir sıra yoktur; kullanıcı, birkaç kaynaktan derlenmiş bir metin okur. Bu yüzden AI görünürlüğü üç ayrı soruya bölünerek ele alınır:
- Anılma: Konuyla ilgili bir soruda markanız cevabın içinde geçiyor mu?
- Doğru tanımlanma: Geçiyorsa, ne yaptığınız, nerede olduğunuz ve neyi sunduğunuz doğru anlatılıyor mu? Eski bir fiyat, kapanmış bir şube ya da başka bir şirketle karıştırılma, görünürlüğün olumsuz yüzüdür.
- Kaynak gösterilme: Cevap, sitenizi bir kaynak atfı olarak bağlantılıyor mu?
Bir marka sık anılıp hiç kaynak gösterilmeyebilir ya da kaynak gösterildiği hâlde yanlış tarif edilebilir. Bu boyutları ayrı ayrı izlemek, hangi sorunun çözülmesi gerektiğini netleştirir.
Ölçüm neden örnekleme ile yapılır?
Yapay zekâ cevapları deterministik değildir. Aynı soru, aynı gün içinde bile farklı ifadelerle ve farklı kaynaklarla cevaplanabilir. Model sürümü güncellenir, web araması bazen devreye girer bazen girmez; kullanıcının konumu, dili ve oturum geçmişi sonucu etkileyebilir. Bu nedenle güvenilir bir ölçüm şu ilkelere dayanır:
- Hedef kitlenin gerçekten soracağı sorulardan oluşan sabit bir soru seti hazırlamak (marka adı geçen ve geçmeyen sorular birlikte).
- Her soruyu birden fazla kez ve birden fazla sistemde çalıştırmak.
- Tarihi, ürünü, dili ve mümkünse konumu kaydetmek.
- Tek bir ekran görüntüsünden değil, dönemler arası eğilimden sonuç çıkarmak.
| Gösterge | Neyi anlatır? |
|---|---|
| Anılma oranı | Soru setindeki cevapların yüzde kaçında marka geçiyor |
| Kaynak gösterilme oranı | Cevapların yüzde kaçında sitenize bağlantı veriliyor |
| Doğruluk | Markayla ilgili ifadelerin kaçı güncel ve doğru |
| Rakiplere göre pay | Aynı sorularda rakiplerin ne sıklıkla anıldığı |
Bu göstergeler sizin seçtiğiniz örneklemden üretilen tahminlerdir. Platformların kendi raporları ise henüz sınırlıdır: Google Search Console'un üretken yapay zekâ performans raporu yalnızca gösterim verisi sunar, Bing Webmaster Tools'un AI Performance raporu da Microsoft'un kendi yüzeyleriyle sınırlıdır. Bu yüzden örnekleme ile platform raporlarını birlikte okumak daha sağlıklıdır.
Görünürlüğü neler etkiler?
Hiçbir sağlayıcı cevaplarına hangi markaları nasıl seçtiğini ayrıntılı biçimde açıklamaz. Yine de bazı temeller makul biçimde önem taşır: sitenin taranabilir ve dizinde olması, marka bilgisinin tutarlı ve net bir varlık tanımı oluşturması, içeriğin kolayca alıntılanabilir pasajlar içermesi ve markanın bağımsız kaynaklarda doğru anlatılması. Bu çalışmaların bütününe GEO adı verilir.
Yanlış tanımlanma ve halüsinasyon
Model web'den güncel bir kaynak getirmeden cevap ürettiğinde, eğitim verisindeki eski ya da eksik bilgilere dayanabilir; bu da halüsinasyon denen uydurma veya hatalı ifadelere yol açabilir. Kendi sitenizde açık, güncel ve tutarlı bilgi sunmak bu riski ortadan kaldırmaz ama web'e dayanan cevaplarda doğru bilginin bulunabilmesini kolaylaştırır.
Hazırlık ile görünürlüğü karıştırmayın
Doruva'nın GEO Analiz Aracı gibi denetimler, bir sayfanın yapay zekâ sistemlerine ne kadar hazır olduğunu (tarayıcı erişimi, şema, alıntılanabilirlik) kontrol eder; markanızın cevaplarda gerçekten görünüp görünmediğini ölçmez. Hazırlık bir ön koşuldur; görünürlük ise ancak gerçek sorularla yapılan tekrarlı gözlemle anlaşılır.