

DOM (Document Object Model) Nedir?
Kısa tanım
DOM (Document Object Model), tarayıcının bir HTML belgesini ayrıştırdıktan sonra bellekte oluşturduğu, öğeleri, metinleri ve özellikleri iç içe düğümler hâlinde tutan ağaç yapısıdır. JavaScript sayfayı bu ağaç üzerinden okur ve değiştirir; ekranda gördüğünüz içerik de HTML kaynak kodundan değil, DOM'un o anki durumundan çizilir. DOM, WHATWG tarafından yaşayan bir standart olarak tanımlanır.
Diğer adları: Belge Nesne Modeli, DOM ağacı, rendered DOM
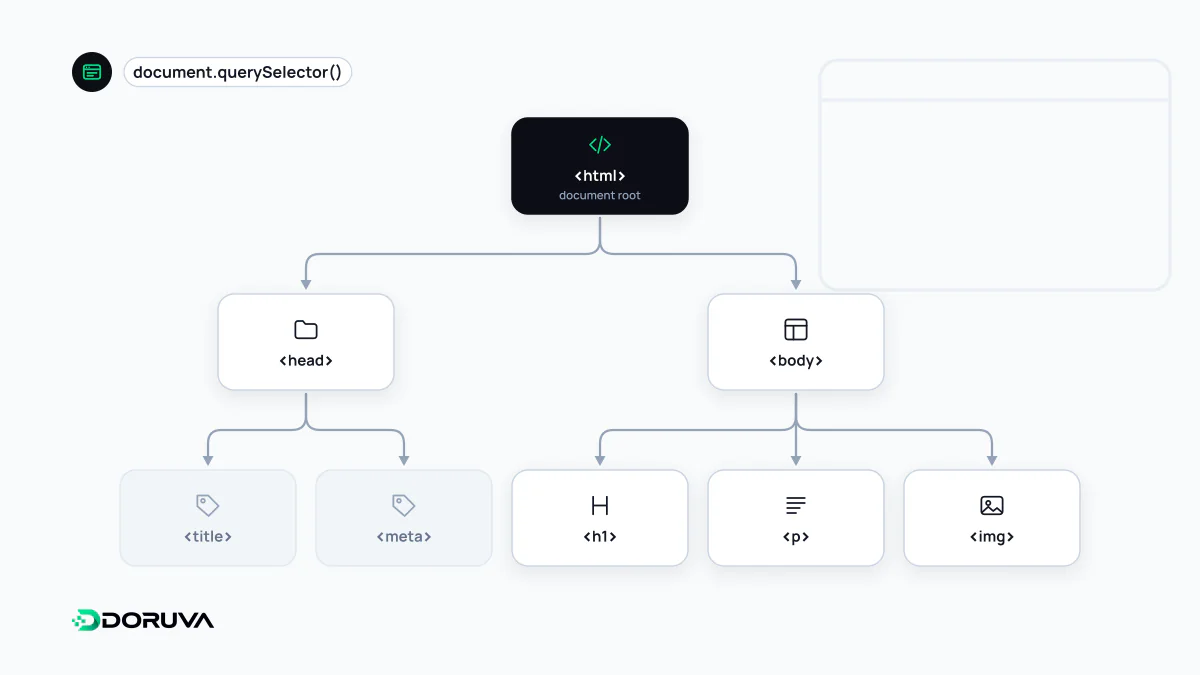
Kaynak kod ile DOM aynı şey değil
Sunucudan gelen HTML bir metin dosyasıdır. Tarayıcı bu metni ayrıştırır (parse) ve her etiketi, metni ve yorumu bir düğüm (node) olarak ağaca yerleştirir: en üstte document, altında html, onun altında head ve body, oradan da dallanarak devam eder. Bu sırada tarayıcı hataları da onarır: kapanmamış etiketleri kapatır, tablolara eksik tbody öğesini ekler, kurallara aykırı iç içe geçmiş öğeleri yeniden düzenler. Ardından JavaScript devreye girer ve ağaca yeni düğümler ekleyebilir, mevcutları silebilir ya da değiştirebilir.
Bu yüzden aslında iki farklı “sayfa” vardır:
- Ham HTML: tarayıcıda “Sayfa kaynağını görüntüle” ile açılan, sunucunun gönderdiği metin.
- Oluşturulmuş (rendered) DOM: geliştirici araçlarının Elements panelinde görülen, ayrıştırma ve JavaScript sonrası güncel hâl.
Tamamen istemci tarafında oluşturulan bir uygulamada ham HTML neredeyse boş bir kabukken DOM yüzlerce öğe içerebilir.
JavaScript DOM ile nasıl çalışır?
DOM, belgeyi programlanabilir hâle getiren bir arayüzdür; yani tarayıcının sunduğu bir API. Tipik işlemler şöyle görünür:
const baslik = document.querySelector("h1");
baslik.textContent = "Güncel kampanyalar";

const liste = document.createElement("ul");
document.body.append(liste);

document.querySelector("button")
  .addEventListener("click", () => { liste.hidden = !liste.hidden; });
DOM'u değiştirmenin bir maliyeti vardır: her değişiklikten sonra tarayıcı stilleri yeniden hesaplar, yerleşimi günceller ve ekranı yeniden boyar. Çok büyük bir DOM ağacı bellek kullanımını artırır ve bu hesaplamaları yavaşlatır; sonuçta etkileşimlere geç yanıt verilir ve INP değeri kötüleşebilir. Lighthouse, aşırı büyük DOM ağaçlarını bu nedenle ayrıca raporlar.
İki kavram sık karıştırılır. React gibi kütüphanelerin kullandığı virtual DOM standardın parçası değildir; arayüzün JavaScript'te tutulan bir kopyasıdır ve gerçek DOM'a yapılacak değişiklikleri en aza indirmek için kullanılır. Shadow DOM ise standarttır ve bir bileşenin iç yapısını ve stillerini sayfanın geri kalanından yalıtır.
Arama motorları DOM'u nasıl görür?
Google sayfaları üç aşamada işler: tarama, oluşturma (rendering) ve dizine ekleme. Googlebot önce ham HTML'i alır; ardından sayfa, güncel Chromium sürümüyle çalışan bir tarayıcıda oluşturulur ve JavaScript çalıştıktan sonraki DOM'dan elde edilen HTML dizine eklemede kullanılır. Yani JavaScript ile eklenen içerik Google tarafından görülebilir. Ancak oluşturma ayrı bir adımdır ve gecikebilir; betik hata verirse ya da engellenmiş bir kaynağa bağlıysa içerik hiç oluşmaz. Ayrıca her tarayıcı JavaScript çalıştırmaz.
Bu nedenle ana içeriğin, iç bağlantıların ve meta etiketlerin ham HTML'de bulunması en sağlam yoldur. Ayrıntılar için JavaScript SEO ve SSR maddelerine bakabilirsiniz.
Nasıl kontrol edilir?
Bir içeriğin ham HTML'de mi yoksa yalnızca DOM'da mı olduğunu anlamak için “Sayfa kaynağını görüntüle” çıktısında arama yapın ve sonucu Elements paneliyle karşılaştırın. Google'ın gördüğü oluşturulmuş HTML'i Search Console'daki URL Denetleme aracı gösterir. Doruva'nın SEO Analiz Aracı da sunucu yanıtı ile tarayıcıda oluşturulmuş sayfayı karşılaştırarak yalnızca JavaScript sonrasında ortaya çıkan başlık, bağlantı ve içerikleri işaretler. Arayüzün kendisi için MDN'in DOM başvurusu kapsamlı bir kaynaktır.