

CCBot (Common Crawl) Nedir?
Kısa tanım
CCBot, kâr amacı gütmeyen Common Crawl vakfının web tarayıcısıdır. Topladığı sayfalar, herkesin ücretsiz indirebildiği açık bir web arşivine eklenir ve bu arşiv pek çok büyük dil modeli eğitim veri setinin ham kaynağıdır. Kendini CCBot/2.0 kullanıcı aracısıyla tanıtır, robots.txt kurallarına ve Crawl-delay yönergesine uyar.
Diğer adları: CCBot, Common Crawl, Common Crawl botu, Common Crawl tarayıcısı
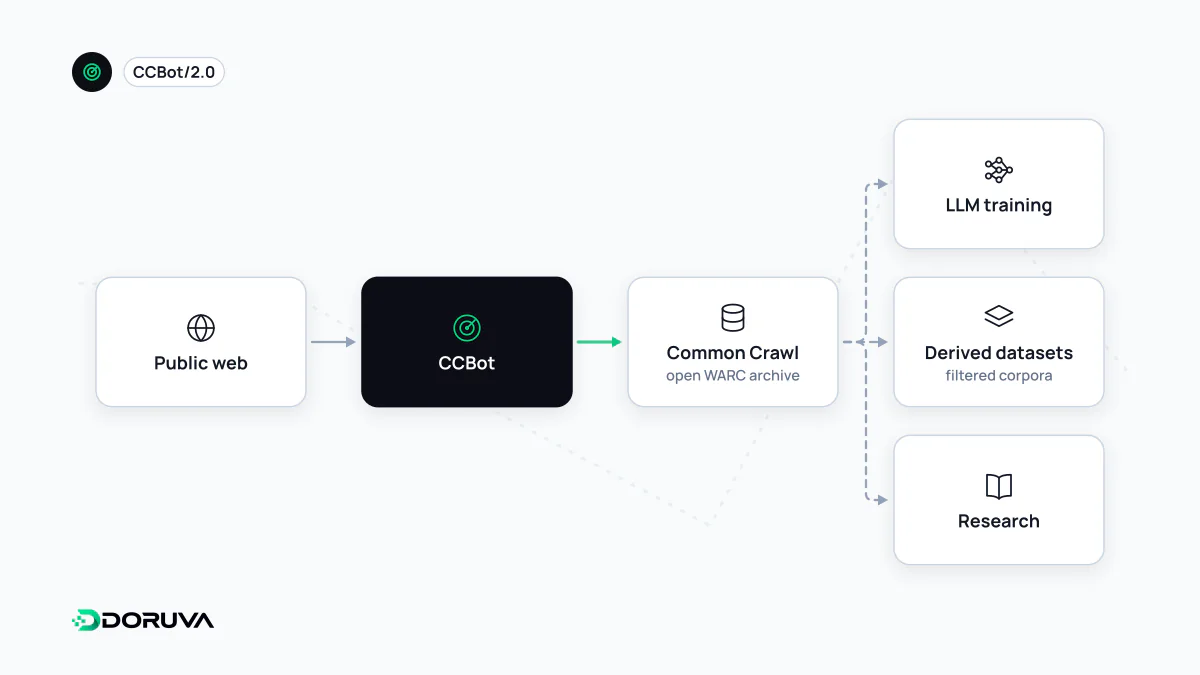
Common Crawl arşivi ve CCBot'un görevi
Common Crawl, 2007'de kurulmuş, ABD'de 501(c)(3) statüsünde kâr amacı gütmeyen bir vakıftır. Web'in geniş bir örneklemini düzenli olarak tarar ve bu arşivi araştırmacılara, şirketlere ve bireylere ücretsiz sunar. Arşivi dolduran tarayıcı CCBot'tur. Vakfın açıklamasına göre CCBot, Apache Nutch tabanlıdır ve Hadoop altyapısında çalışır: tarama adayları alan adına göre sıralanıp bir grup tarayıcı sunucusuna dağıtılır. Toplanan veriler Amazon S3 üzerinde tutulur; toplu olarak indirilebilir ya da bulutta doğrudan işlenebilir.
Arşiv bir örneklemdir. Common Crawl hiçbir siteyi bütünüyle arşivlemediğini, rastgele seçilmiş bir alt kümeyi aldığını belirtir. CCBot'un sitenize uğramış olması, tüm sayfalarınızın arşive girdiği anlamına gelmez.
Dil modeli eğitimiyle bağlantısı
CCBot bir yapay zekâ şirketinin tarayıcısı değildir ve kendisi model eğitmez. Önemi, ürettiği açık verinin başkaları tarafından nasıl kullanıldığından gelir. Common Crawl verisi, büyük dil modelleri için hazırlanan pek çok eğitim veri setinin ham maddesidir. Bilinen bir örnek: OpenAI'ın 2020'de yayımladığı GPT-3 makalesi, eğitim karışımının en büyük bileşeni olarak kalite filtresinden geçirilmiş bir Common Crawl sürümünü listeler (yaklaşık 410 milyar token, karışımın %60'ı). Vakıf da veri setine 10.000'i aşkın araştırma makalesinde atıf yapıldığını belirtir.
Bu yüzden CCBot, yapay zekâ tarayıcıları tartışılırken sık sık "eğitim verisi toplayan botlar" grubunda anılır. Ancak arada bir halka daha vardır: Common Crawl veriyi yayımlar, hangi model geliştiricisinin bu veriyi nasıl filtreleyip kullandığına ise vakıf karar vermez.
Kullanıcı aracısı ve robots.txt kuralları
CCBot kendini CCBot/2.0 (https://commoncrawl.org/faq/) kullanıcı aracısıyla tanıtır; robots.txt'deki token'ı CCBot'tur. Siteyi tamamen kapatmak için:
User-agent: CCBot
Disallow: /
Engellemek yerine yalnızca yükü azaltmak istiyorsanız, CCBot Crawl-delay yönergesine uyduğunu belirtir. Aşağıdaki kural, aynı siteye iki saniyede birden sık istek gönderilmemesini ister:
User-agent: CCBot
Crawl-delay: 2
Vakfın belgelediği diğer davranışlar şunlardır: önce robots.txt okunur, izin verilen sayfalar HTTP GET ile çekilir; HTTP/1.1 ve yalnızca TLS üzerinden HTTP/2 desteklenir; JavaScript çalıştırılmaz, çerez kullanılmaz; robots.txt'de bildirilen site haritaları kullanılır; sunucu 429 ya da 5xx döndürdüğünde tarama yavaşlatılır; sayfadaki nofollow bağlantılar takip edilmez. JavaScript çalıştırılmaması önemli bir ayrıntıdır: içeriği yalnızca tarayıcıda oluşan sayfalar arşive boş ya da eksik girer.
Gerçek CCBot'u taklitlerinden ayırmak
Common Crawl, kendini CCBot olarak tanıtan sahte tarayıcılar bulunduğunu açıkça yazar; kullanıcı aracısı tek başına kanıt değildir. Gerçek CCBot sabit IP aralıklarından çalışır ve IPv4 adresleri ters DNS ile doğrulanabilir: IP adresinin PTR kaydı crawl.commoncrawl.org ile biten bir ana makine adına çıkmalı, o ad da aynı IP adresine geri çözülmelidir.
$ host 18.97.14.84
84.14.97.18.in-addr.arpa domain name pointer 18-97-14-84.crawl.commoncrawl.org.
$ host 18-97-14-84.crawl.commoncrawl.org
18-97-14-84.crawl.commoncrawl.org has address 18.97.14.84
IPv6 tarafında ters DNS henüz desteklenmediği için güncel IPv4 ve IPv6 aralıklarını vakfın yayımladığı ccbot.json dosyasıyla karşılaştırmak gerekir. Sunucu kayıtlarında bu ayrımı yapmak, log dosyası analizinde bot trafiğini doğru sınıflandırmanın ön koşuludur.
Engellemek neyi değiştirir, neyi değiştirmez?
- Değiştirir: İçeriğiniz bundan sonraki Common Crawl taramalarına girmez; dolayısıyla bu taramalardan türetilecek veri setlerine dolaylı yoldan dahil olması da sınırlanır.
- Değiştirmez: Daha önce arşivlenmiş kopyalar robots.txt değişikliğiyle geri alınmaz; veriyi önceden indirmiş kişiler de bundan etkilenmez. Hukuki talepler için vakıf ayrı bir süreç işletir ve aldığı çıkarma taleplerini herkese açık bir "Opt-Out Ledger" listesinde yayımlar.
- Arama görünürlüğü: CCBot'u engellemek Google veya Bing'deki görünürlüğü etkilemez. Eğitim amaçlı başka botları, örneğin GPTBot ya da Google-Extended token'ını ayrıca değerlendirmek gerekir; her biri kendi kuralıyla yönetilir.
Hangi eğitim botuna izin verileceği teknik değil, bir içerik politikası kararıdır. GEO Analiz Aracı, robots.txt'nizde CCBot dahil eğitim tarayıcılarının durumunu bilgi amaçlı gösterir; bu botları engellemek skoru etkilemez. Davranışların güncel tanımı için kaynak Common Crawl SSS sayfasıdır.