

Bot Erişilebilirliği Nedir?
Kısa tanım
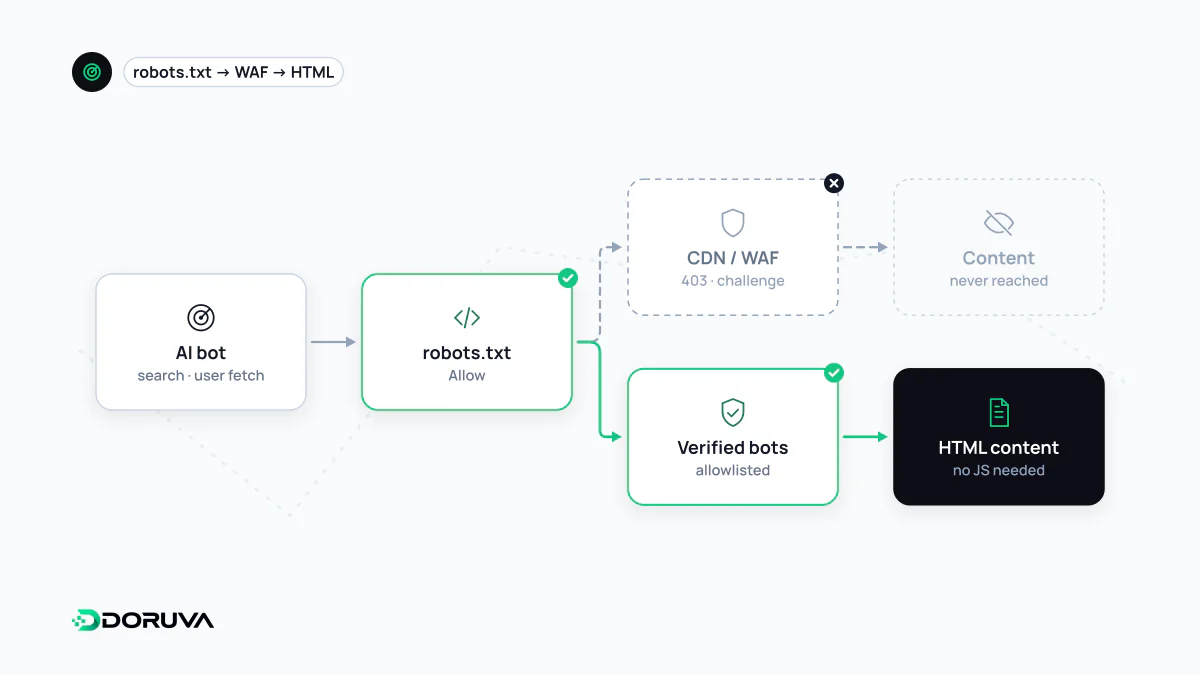
Bot erişilebilirliği, arama motoru ve yapay zekâ botlarının bir sitenin sayfalarına gerçekten ulaşıp içeriğini okuyabilmesidir. robots.txt izinlerinin yanında güvenlik duvarı ve bot koruması engellerini, HTTP durum kodlarını, hız sınırlamasını ve içeriğin yalnızca JavaScript ile oluşup oluşmadığını kapsar. robots.txt'de izin verilen bir bot, bu katmanlardan birinde durdurulursa içeriği yine göremez.
Diğer adları: bot erişimi, bot accessibility, AI bot erişimi, crawler access, yapay zekâ botu erişimi
robots.txt izni neden yetmez?
Bir sitenin yapay zekâ ve arama botlarına açık olup olmadığı çoğu zaman yalnızca robots.txt dosyasına bakılarak söylenir. Oysa robots.txt bir izin beyanıdır. Bir botun isteği sayfanın içeriğine ulaşana kadar birkaç katmandan geçer ve her biri isteği durdurabilir:
- robots.txt: Bot, kendi adına yazılmış grubu ya da
User-agent: *grubunu okur ve izinli yolları belirler. - CDN, güvenlik duvarı ve bot koruması: İstek sunucuya ulaşmadan bir WAF ya da bot yönetimi kuralıyla engellenebilir veya bir doğrulama sayfasına yönlendirilebilir.
- Hız sınırlama: Kısa sürede çok istek yapan bot 429 Too Many Requests yanıtı alabilir.
- Sunucu yanıtı: Sayfa 200 yerine 403, 5xx ya da giriş sayfasına yönlendirme dönüyorsa bot içerik görmez.
- HTML içeriği: Yanıt 200 olsa bile metin yalnızca JavaScript çalıştıktan sonra oluşuyorsa, JavaScript çalıştırmayan bir bot boş bir iskelet okur.
- Yönergeler:
noindexya danosnippetgibi yönergeler, alınan içeriğin nasıl kullanılabileceğini sınırlar.
Bot erişilebilirliği, bu zincirin tamamının istenen botlar için açık olmasıdır.
Sık görülen engeller ve belirtileri
| Engel | Bot ne görür? | Nasıl fark edilir? |
|---|---|---|
| Doğrulama (challenge) sayfası | CAPTCHA ya da JavaScript sınaması içeren bir ara sayfa, çoğu zaman 403 veya 503 koduyla | Kayıtlarda bot isteklerinin içerik yerine sınama yanıtı alması |
| CDN'deki yapay zekâ botu engelleme ayarı | 403 ya da bağlantı reddi | Güvenlik paneli ayarları; robots.txt izin verdiği halde başarılı ziyaret olmaması |
| Hız sınırı | 429 yanıtları | Kayıtlarda bot başına durum kodu dağılımı |
| Ülke ya da IP engeli | 403 ya da zaman aşımı | Botun yayımlanmış IP aralıklarının engellenen bölgelerle karşılaştırılması |
| Yalnızca JavaScript ile oluşan içerik | Boş ya da eksik HTML | Ham HTML ile tarayıcıda oluşan DOM'un karşılaştırılması |
Doğrulama sayfaları özellikle önemlidir, çünkü iyi niyetli botlar onları aşmaya çalışmaz. Anthropic, botlarının CAPTCHA gibi atlatma önleyici teknolojilere saygı gösterdiğini ve bunları aşmaya çalışmadığını açıkça belirtir. Yani sitenizi kötü niyetli trafikten korumak için kurulan bir önlem, istemeden yapay zekâ aramasındaki görünürlüğü de kapatabilir. Perplexity de bot belgesinde, WAF kullanan sitelerin botlarına açıkça izin vermesi gerekebileceğini yazar ve bunun için user-agent eşleşmesiyle yayımlanmış IP aralıklarının birlikte kullanılmasını önerir.
JavaScript ile oluşan içerik
Google, Googlebot'un sayfaları taradıktan sonra bir render aşamasından geçirdiğini, yani JavaScript'i çalıştırdığını belgeler. Apple da Applebot'un sayfaları bir tarayıcı içinde render edebileceğini söyler. Buna karşılık birçok yapay zekâ sağlayıcısı, botlarının JavaScript çalıştırıp çalıştırmadığını belgelemez. Belgelenmemiş bir davranışa güvenmek yerine, önemli metnin sunucudan gelen ilk HTML'de bulunmasını sağlamak en güvenli yoldur. Arama motoru tarafı JavaScript SEO maddesinde ele alınıyor.
Bir botun gözünden test etmek
Hızlı bir ilk kontrol, isteği belgelenmiş bir bot user-agent'ıyla gönderip durum kodunu ve gövdeyi incelemektir. Örnekte OpenAI'nin ChatGPT-User için yayımladığı dize kullanılıyor:
curl -s -o sayfa.html -w "%{http_code}
"   -A "Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; ChatGPT-User/1.0; +https://openai.com/bot"   https://ornek.com/hizmetler/

grep -c "Hizmetlerimiz" sayfa.html
Durum kodu 200 değilse ya da beklenen metin dosyada yoksa bir engel vardır. Bu testin bir sınırı da var: istek sizin IP adresinizden çıkar. Birçok güvenlik hizmeti bilinen botları IP aralıklarına göre de tanıdığından, gerçek bot farklı bir muamele görebilir. Kesin tablo için gerçek bot isteklerinin sunucu kayıtlarında hangi durum kodlarını aldığına bakmak gerekir; yöntem log dosyası analizi maddesinde anlatılıyor.
Erişilebilir olmak herkese açık olmak demek değildir
Amaç her botu içeri almak değil, hangi bota neye izin verildiğinin bilinçli bir karar olmasıdır. Model eğitimi için içerik toplayan botları engellemek meşru bir tercihtir; arama ve kullanıcı isteğiyle çalışan botları engellemek ise içeriğin yapay zekâ cevaplarında kaynak olarak kullanılma ihtimalini düşürür. Bu ayrım yapay zekâ tarayıcısı maddesinde ayrıntılı anlatılıyor. Kendini tanınmış bir bot gibi gösteren sahte istekler ise sağlayıcıların yayımladığı IP listeleriyle ayıklanabilir. Doruva'nın GEO Analiz Aracı, robots.txt'nin başlıca arama, kullanıcı isteği ve eğitim botlarına verdiği izinleri, bot doğrulama sayfalarını ve yalnızca JavaScript ile oluşan içeriği kontrol eder.