

Taranabilirlik (Crawlability) Nedir?
Kısa tanım
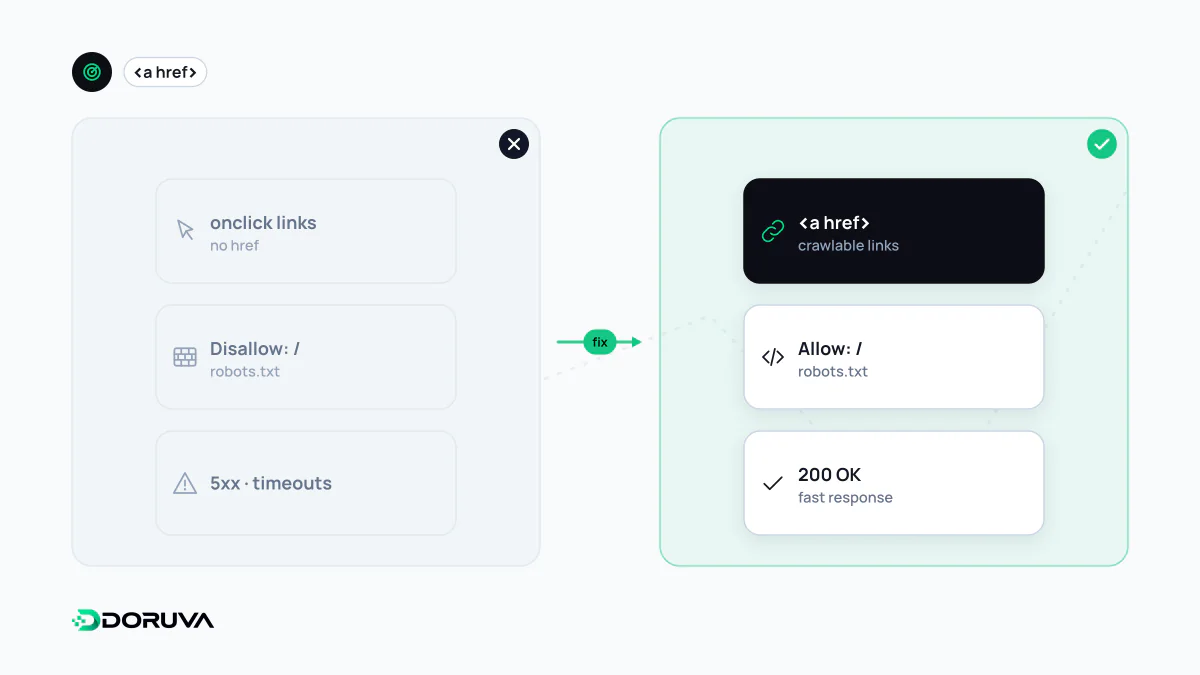
Taranabilirlik (crawlability), bir web sitesinin arama motoru tarayıcılarının sayfalara ulaşmasına, onları indirmesine ve içlerindeki bağlantıları izlemesine ne ölçüde imkân verdiğini anlatan özelliğidir. Bağlantı yapısı, robots.txt kuralları, sunucunun döndürdüğü durum kodları ve yanıt süresi, güvenlik katmanlarının botlara davranışı ve bağlantıların JavaScript'e bağımlılığı taranabilirliği belirler.
Diğer adları: crawlability, taranabilir site, tarama erişilebilirliği
Süreç değil, sitenin bir özelliği
Tarama, Googlebot gibi bir programın URL'leri isteyip indirdiği süreçtir. Taranabilirlik ise bu süreç başladığında sitenin karşısına ne çıkardığıyla ilgilidir: Bot sayfaya yol bulabiliyor mu, sunucu ona içerik veriyor mu, sayfadaki bağlantıları okuyup bir sonraki adrese geçebiliyor mu? Aynı tarayıcı iki farklı siteye aynı bütçeyle gelse bile, biri tüm önemli sayfalarını birkaç gün içinde taratırken diğerinde yüzlerce sayfa hiç bulunamayabilir. Fark tarayıcıda değil, sitenin yapısındadır.
Bir botun sayfaya ulaşması için gereken dört şey
- Bulunabilirlik: URL'ye başka bir sayfadan bağlantı verilmeli ya da site haritasında yer almalıdır. Hiçbir yerden bağlantı almayan yetim sayfalar ancak site haritası veya dış bağlantı sayesinde bulunabilir.
- İzin: robots.txt dosyası ilgili yolu engellememelidir. Sayfanın görünümü için gereken CSS ve JavaScript dosyalarının engellenmesi de dolaylı bir taranabilirlik sorunudur.
- Erişim: Sunucu makul sürede yanıt vermeli, kalıcı 5xx hataları ya da giriş duvarı olmamalıdır. CDN veya güvenlik duvarındaki bot koruması kuralları gerçek arama motoru botlarını da durdurabilir; bu, log'lara bakmadan fark edilmesi zor bir hatadır.
- Okunabilir bağlantılar: Bot bir sonraki sayfaya ancak ayrıştırabildiği bağlantılar üzerinden geçer.
Bot için bağlantı sayılmayan bağlantılar
Google, bir bağlantıyı güvenilir biçimde takip edebilmesi için href özelliği olan bir <a> öğesi ve çözümlenebilir bir URL gerektiğini açıkça belirtir. Kullanıcı için aynı görünen şu öğeler bot için aynı değildir:
<!-- Taranabilir -->
<a href="/hizmetler/seo/">SEO hizmeti</a>

<!-- Taranamaz: href yok, gezinme yalnızca tıklama olayıyla -->
<span onclick="git('/hizmetler/seo/')">SEO hizmeti</span>

<!-- Taranamaz: javascript: adresi çözümlenemez -->
<a href="javascript:git('seo')">SEO hizmeti</a>
Menü, filtre ve "daha fazla yükle" düğmeleri bu kalıbın en sık görüldüğü yerlerdir. Ayrıntılı örnekler Google'ın taranabilir bağlantılar belgesinde yer alır.
Taranabilir olmak dizine girmeye yetmez
Taranabilirlik zincirin ilk halkasıdır. noindex taşıyan bir sayfa tamamen taranabilir olabilir ama dizine girmez; tersine, robots.txt ile engellenmiş ve dolayısıyla taranamayan bir URL dış bağlantı alıyorsa açıklamasız biçimde sonuçlarda görünebilir. Sayfanın dizin için uygun olup olmadığı ayrı bir sorudur ve dizine eklenebilirlik başlığı altında ele alınır.
Taranabilirliği denetlemek
- Kendi taramanızı yapın: Bir tarama aracını ana sayfadan başlatıp yalnızca bağlantıları izleyerek hangi sayfalara ulaşılabildiğini görün; site haritasındaki URL listesiyle karşılaştırın. Haritada olup taramada çıkmayan sayfalar bağlantı yapısındaki boşlukları gösterir.
- Sunucu log'larına bakın: Log dosyası analizi, botların gerçekte hangi URL'leri, hangi durum kodlarıyla istediğini ortaya koyar.
- Search Console'u izleyin: Tarama istatistikleri raporu yanıt süresi ve durum kodu dağılımını, URL Denetimi ise tek bir sayfanın Google tarafından alınıp alınamadığını gösterir.
Bağlantı, robots.txt ve durum kodu sorunlarını örneklem bir taramayla hızlıca görmek için SEO Analiz Aracı da kullanılabilir.