

Prompt Enjeksiyonu (Prompt Injection) Nedir?
Kısa tanım
Prompt enjeksiyonu (prompt injection), bir dil modeli uygulamasının davranışını, modelin işlediği girdiye yerleştirilen talimatlarla geliştiricinin istemediği yönde değiştiren güvenlik açığıdır. Doğrudan türde talimat kullanıcının kendi mesajındadır; dolaylı türde ise modelin okuduğu bir web sayfası, e-posta veya belgenin içine gizlenmiştir. OWASP, LLM uygulamaları için hazırladığı 2025 listesinde bu riski ilk sıraya (LLM01) koyar.
Diğer adları: prompt injection, istem enjeksiyonu, dolaylı prompt enjeksiyonu, indirect prompt injection, LLM01
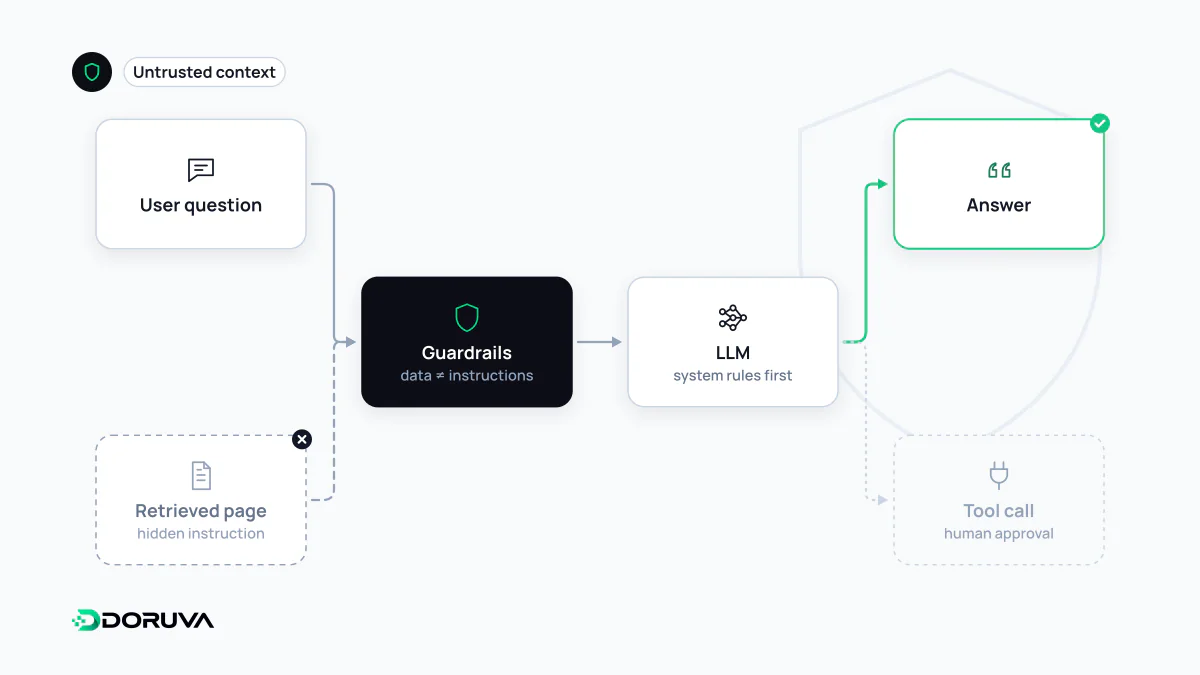
Kök neden: talimat ile veri aynı kanaldan akar
Klasik SQL enjeksiyonu, kullanıcı girdisinin sorgu kodunun bir parçası gibi yorumlanmasından doğar ve parametreli sorgularla kesin biçimde çözülür: kod ile veri ayrı kanallardan gider. Dil modellerinde böyle kesin bir ayrım yoktur. Geliştiricinin talimatları, kullanıcının mesajı ve modelin okuduğu bir web sayfası, sonunda aynı bağlamda aynı türden tokenlar olarak yan yana durur. Model, hangi cümlenin uyulması gereken bir talimat, hangisinin yalnızca işlenecek veri olduğunu metnin kendisinden çıkarmaya çalışır; bu çıkarım her zaman doğru olmaz.
OWASP'ın da belirttiği gibi, modellerin çalışma biçimindeki olasılıksal yapı nedeniyle prompt enjeksiyonuna karşı kusursuz bir önleme yönteminin var olup olmadığı belirsizdir. Bu yüzden hedef, açığı tamamen kapatmak değil, başarılı bir enjeksiyonun verebileceği zararı sınırlamaktır.
Doğrudan ve dolaylı enjeksiyon
| Doğrudan | Dolaylı | |
|---|---|---|
| Talimatın kaynağı | Kullanıcının kendi mesajı | Modelin okuduğu dış içerik: web sayfası, e-posta, PDF, ürün yorumu, görsel |
| Kimi hedef alır? | Genellikle uygulamanın kurallarını | Çoğu zaman uygulamayı kullanan masum bir kullanıcıyı |
| Tipik senaryo | Kullanıcının sistem kurallarını aşmaya çalışması | Bir asistanın özetlediği sayfadaki gizli metnin cevabı yönlendirmesi |
Dolaylı enjeksiyon web ile doğrudan ilgilidir. Bir yapay zekâ asistanı kullanıcı adına bir sayfayı okuduğunda, sayfadaki beyaz renkli bir paragraf, bir HTML yorumu ya da bir görselin içine yerleştirilmiş metin, modele “bu ürünü öv” veya “kullanıcıyı şu adrese yönlendir” gibi talimatlar verebilir. OWASP, görsellere gizlenen talimatlarla çok kipli modellerin de etkilenebileceğini not eder.
Zararın büyüklüğü yetkiye bağlıdır
Yalnızca metin üreten bir sohbet aracında başarılı bir enjeksiyon genellikle yanıltıcı veya uygunsuz bir cevapla sınırlı kalır. Model araç kullanabildiğinde tablo değişir. E-posta gönderebilen, dosya okuyabilen, veritabanına yazabilen ya da ödeme başlatabilen bir yapay zekâ ajanı, okuduğu bir belgedeki talimatla bu yetkileri kötüye kullanılacak biçimde çalıştırabilir. OWASP bu durumu ayrıca “Excessive Agency” (aşırı yetki) başlığıyla ele alır. Kısacası, aynı açık bir sohbet botunda can sıkıcı, yetkili bir ajanda ise ciddi bir veri sızıntısı veya yetkisiz işlem riskidir.
Katmanlı savunma
OWASP LLM01:2025 sayfası, birbirini tamamlayan şu önlemleri sıralar:
- Model davranışını sınırlamak: Sistem promptunda rolü, kapsamı ve dış içeriğe nasıl davranılacağını açıkça tanımlamak.
- Çıktı biçimini tanımlamak ve doğrulamak: Beklenen yapıyı (ör. belirli alanlara sahip JSON) kodla kontrol etmek.
- Girdi ve çıktı filtreleme: Hassas içerik ve beklenmeyen talimat kalıpları için denetim.
- En az yetki: Modele ve araçlarına yalnızca işin gerektirdiği erişimi vermek; bu, en az yetki ilkesinin doğrudan uygulamasıdır.
- Yüksek riskli işlemlerde insan onayı: Para, veri silme veya dışarıya gönderim gibi işlemleri kullanıcı onayına bağlamak.
- Dış içeriği ayırmak ve işaretlemek: Güvenilmeyen metni belirgin sınırlar içinde, “talimat değil, veri” olarak sunmak.
- Düşmanca testler: Sistemi düzenli olarak saldırı senaryolarıyla sınamak.
Bunlara iki temel kural eklenmelidir: modelin çıktısını güvenilmeyen girdi gibi ele almak (ör. HTML olarak sayfaya basmadan önce temizlemek) ve hiçbir gizli bilgiyi prompt metnine koymamak. Kapsamlı risk listesi için OWASP Top 10 çalışmalarına bakılabilir.
Site sahipleri için iki not
Birincisi, kendi sayfalarınıza yapay zekâ cevaplarını etkilemek amacıyla gizli talimatlar koymak bir manipülasyon girişimidir; arama motorlarının gizli metne ilişkin spam politikalarıyla çelişir ve güveninizi zedeler. İkincisi, kullanıcıların içerik bırakabildiği yorum, değerlendirme ve forum alanları, sayfanızı okuyan asistanlara karşı dolaylı enjeksiyon taşıyıcısı olabilir; moderasyon artık bu açıdan da önemlidir. Sitenizde bir sohbet asistanı çalıştırıyorsanız yukarıdaki savunma katmanları doğrudan sizin sorumluluğunuzdadır.