

Gözlemlenebilirlik (Observability) Nedir?
Kısa tanım
Gözlemlenebilirlik (observability), bir sistemin ürettiği log, metrik ve trace verilerine bakarak içeride ne olduğunu, önceden düşünülmemiş sorular dahil anlayabilme yeteneğidir. İzleme (monitoring) bilinen arıza türleri için eşik ve alarm kurar; gözlemlenebilirlik ise “bu istek neden yavaş?” gibi yeni soruları, yeni kod yazıp yayına almadan, mevcut veriden yanıtlayabilmeyi hedefler.
Diğer adları: observability, o11y, monitoring, izleme, APM, metrik
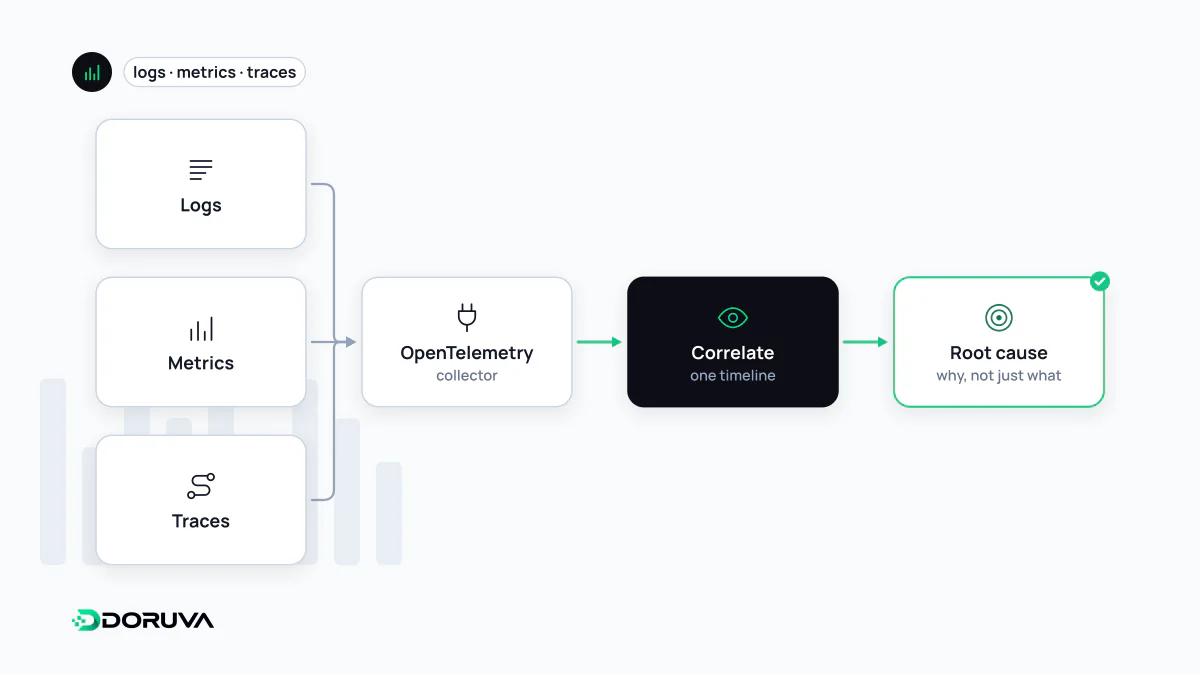
İzleme ile gözlemlenebilirlik arasındaki çizgi
İzleme (monitoring), önceden bilinen sorular için kurulur: “CPU %90'ı geçti mi?”, “disk doluyor mu?”, “hata oranı %1'in üstünde mi?” Bu sorular değerlidir ama yalnızca tahmin edilmiş arızaları yakalar. Modern uygulamalarda arızaların çoğu ilk kez görülen bileşimlerdir: belirli bir mobil sürümden, belirli bir ödeme yöntemiyle gelen isteklerin yalnızca bir veritabanı kopyasında yavaşlaması gibi.
Gözlemlenebilirlik, bu tür sorulara yeni kod yazıp yayına almadan, sistemin zaten ürettiği veriyle cevap verebilmektir. Bunun için verinin zengin bağlam taşıması (sürüm, kullanıcı segmenti, uç nokta, bölge) ve bu bağlama göre sorgulanabilmesi gerekir. İzleme gözlemlenebilirliğin yerine geçmez; onun üzerinde çalışan alarm katmanıdır.
Üç temel sinyal
| Sinyal | Yanıtladığı soru | Örnek | Dikkat edilecek nokta |
|---|---|---|---|
| Log | Tam olarak ne oldu? | Ödeme sağlayıcısı “kart reddedildi” döndü, sipariş 1042 | Hacim ve maliyet hızla büyür; hassas veri sızabilir |
| Metrik | Ne kadar, ne sıklıkta, eğilim ne? | Dakikadaki istek sayısı, p95 yanıt süresi, kuyruk derinliği | Ucuz ve hızlıdır ama ayrıntıyı özetler |
| Trace | Zaman nerede harcandı, hata hangi halkada? | Bir ödeme isteğinin beş servisteki adımları | Genellikle örneklenir; tüm istekler kaydedilmez |
Loglama olayların ayrıntısını, metrikler genel sağlığı, dağıtık izleme ise isteklerin servisler arasındaki yolunu verir. Sinyallerin gücü birbirine bağlanabilmelerinden gelir: alarmı tetikleyen metrikten ilgili trace'lere, oradan da o isteğin loglarına tek tıklamayla geçebilmek. Açık standart OpenTelemetry, trace, metrik ve log sinyallerini kararlı olarak tanımlar ve bunları üretici bağımsız biçimde toplamayı sağlar.
Neyi ölçmeli?
Her şeyi ölçmek, hiçbir şeyi görmemekle sonuçlanabilir. Google'ın SRE yaklaşımındaki dört altın sinyal kullanıcıya dönük her servis için iyi bir başlangıçtır:
- Gecikme: İsteklerin ne kadar sürdüğü; ortalama değil yüzdelikler (p50, p95, p99) üzerinden ve başarılı ile başarısız istekler ayrı ayrı. Ayrıntılar için gecikme.
- Trafik: Saniyedeki istek veya işlem sayısı.
- Hatalar: Başarısız isteklerin oranı; 5xx yanıtların yanında “200 döndü ama içerik yanlış” durumları da.
- Doygunluk: Sistemin ne kadar dolu olduğu: CPU, bellek, bağlantı havuzu, kuyruk derinliği.
Sunucu tarafı ölçümler kullanıcının gerçekten ne yaşadığını tam göstermez. Tarayıcıdan toplanan gerçek kullanıcı izleme (RUM) verileri ve düzenli aralıklarla kritik akışları deneyen sentetik testler bu boşluğu doldurur.
Alarm yorgunluğu ve doğru eşik
Her metriğe alarm bağlamak, kısa sürede kimsenin bakmadığı bir bildirim seline dönüşür. Daha sağlıklı yaklaşım, nedenlere değil belirtilere alarm kurmaktır: “bir sunucuda CPU yüksek” yerine “ödeme isteklerinin hata oranı son 10 dakikada hedefi aştı”. Hedefler genellikle servis düzeyi hedefi (SLO) olarak yazılır; örneğin “isteklerin %99,5'i 300 ms altında yanıtlanmalı”. Alarm, kullanıcının etkilendiği ve birinin hemen bir şey yapması gerektiği durumlar için ayrılmalıdır.
APM, araç seçimi ve maliyet
APM (Application Performance Monitoring) araçları, uygulamaya eklenen bir ajan veya SDK ile istek sürelerini, veritabanı sorgularını ve hataları otomatik toplayan ticari veya açık kaynak ürünlerdir. Enstrümantasyonu OpenTelemetry ile yapmak, sonradan aracı değiştirmeyi kolaylaştırır. Maliyetin büyük kısmını genellikle iki şey belirler: log hacmi ve metriklerin kardinalitesi. Bir metriğe kullanıcı kimliği gibi milyonlarca farklı değer alan bir etiket eklemek, zaman serisi sayısını patlatır; bu tür ayrıntı metriğe değil log veya trace'e aittir. Sürüm etiketi ise tam tersine ucuz ve çok değerlidir: canary deployment gibi kademeli yayınlar, metriklerin sürüme göre ayrıştırılabilmesine dayanır.